Cloud Storage — 用中文阅读
故事标题目前仍是英文,正文是中文。
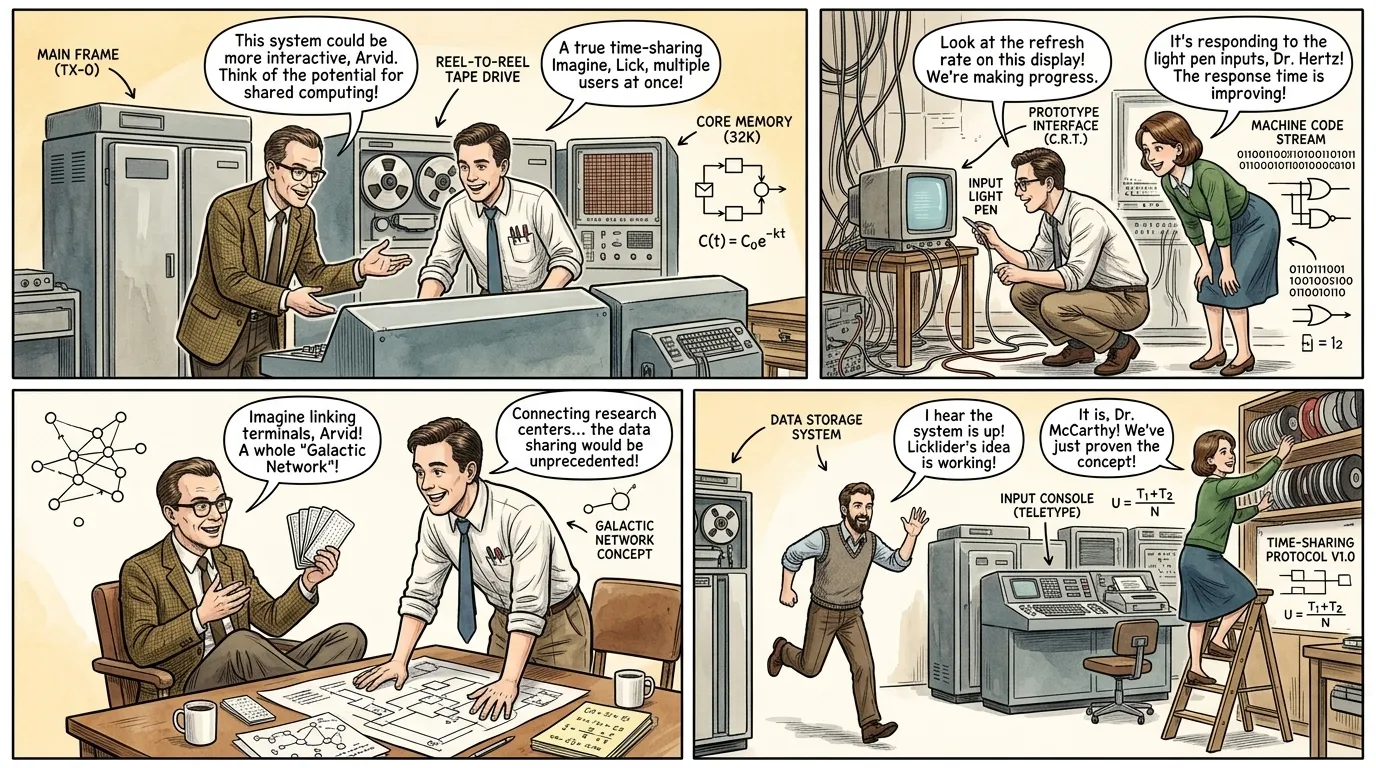
在二十世纪六十年代早期,一个根本性的挑战阻碍了计算潜力的发挥:数据被束缚在特定的机器上,这使得真正的协作工作和跨距离的即时访问成为不可能。研究人员和机构在处理碎片化信息时举步维艰,每一次交互都需要繁琐的物理传输或直接的机器访问。 “利克里德博士,”他的同事阿维德·赫兹博士指着一台卷对卷磁带驱动器说道,“我们的本地存储解决方案正迅速成为一个关键障碍。当每个数据集都是一个孤岛,受限于其物理硬件时,我们如何才能真正共享知识?”麻省理工学院的先驱计算机科学家J.C.R.利克里德若有所思地回答:“确实如此,阿维德。问题不仅仅是存储容量;而是可访问性。我们需要人与机器之间建立一种共生关系,让信息不再是一种物理商品,而是一种流动的资源,可以从任何地点访问。”
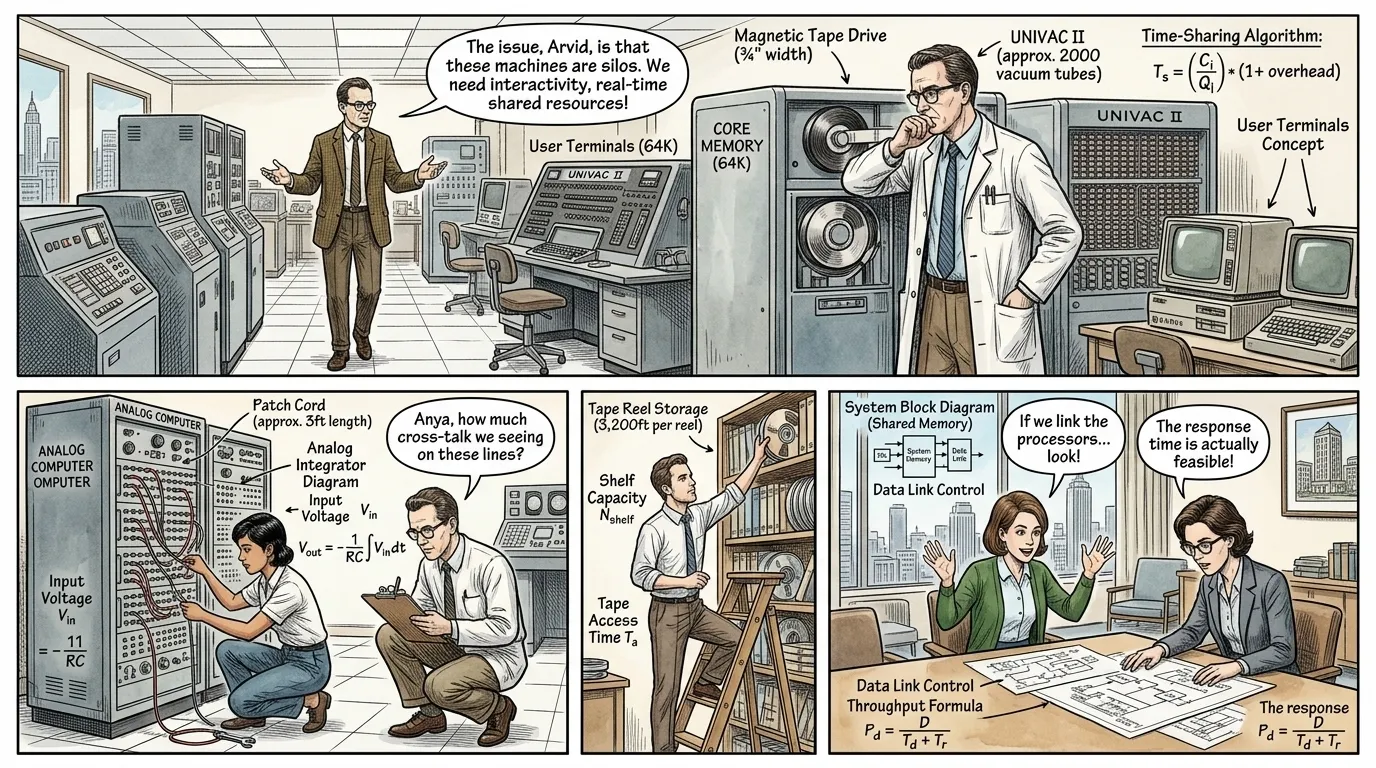
在广泛联网计算出现之前,每个机构,乃至每个人,都在各自独立的数据孤岛中运作。信息存储在打孔卡、磁带或早期的硬盘上,需要直接与存储数据的特定机器进行物理交互。 “想象一下,阿尔维德,”利克莱德继续说道,他在狭窄的、摆满设备的过道里踱步,“那是多么低效啊!加利福尼亚的研究人员需要访问马萨诸塞州这里汇编的数据,将面临数天的延迟,甚至可能数周,只为物理介质的运输。这根本不是协作;这是接连不断的不便。”赫兹点点头说:“还有复制。每个关键数据集都必须在本地复制、存储和管理,这导致了版本控制的噩梦和冗余的基础设施。这就像每个人都需要为每一本书拥有自己的私人图书馆一样。”
实体数据存储的局限性激发了全新的激进思维。有远见的人开始设想这样一个世界:计算资源,包括存储,不再归个人所有,而是作为一种公用事业提供,就像电力或水一样,人人都可以按需使用。 “那么,我们的挑战,”赫兹沉思着,靠在一排嗡嗡作响的服务器机架上说,“是如何超越单台机器。我们必须将计算本身概念化为一种公共事业。但我们如何汇集如此多样化的资源——处理能力、内存、存储——并将它们抽象成一种无缝、统一的服务呢?”利克莱德的眼睛亮了起来。“正是如此,阿维德!我们必须建立一个资源池系统,让大量相互连接的机器共享它们的能力。这种抽象,呈现出一种统一的、看似无限的资源,是关键。正如约翰·麦卡锡后来在他关于‘公用事业计算’的愿景中所阐述的,‘如果计算机要像电话一样易于使用,它们就必须被组织成一种公共事业。’这意味着一个共享的基础设施,而不是单台机器,提供可靠性和规模。这种将底层物理资源抽象为虚拟的、按需服务的概念,是我们所设想的一切的基础。”
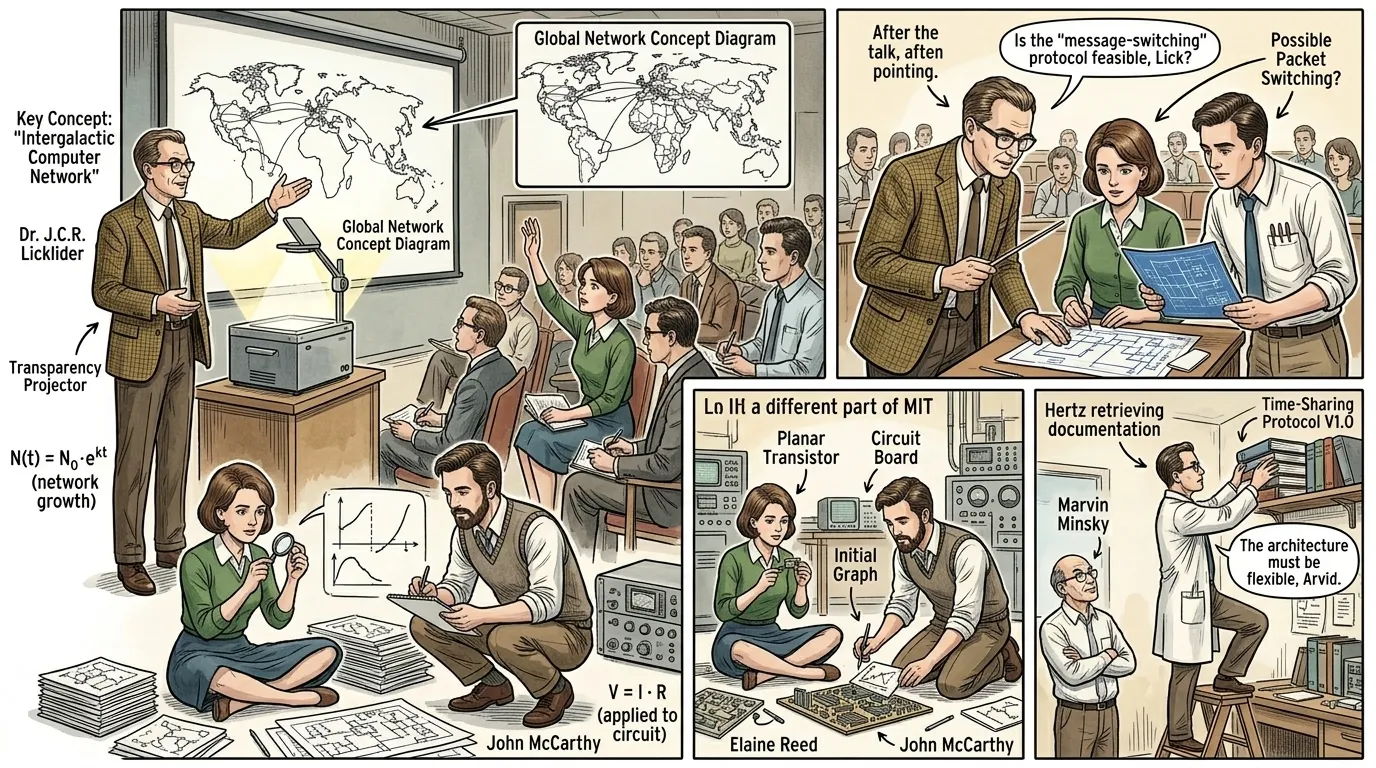
J.C.R. 利克里德的深远愿景超越了简单的分时系统。一九六二年,他阐述了“星际计算机网络”的概念,这是一个连接计算机和用户的庞大全球网络,旨在实现从地球上任何一点普遍访问数据和程序。 “这个网络的本质,”利克里德向一群麻省理工学院的研究人员解释道,他指着透明投影仪上的一张复杂示意图,“不仅仅是连接两台机器,而是培育一个普及的数字公共领域。想象一个全球图书馆,一个巨大的信息和计算能力储存库,任何人、任何地点都可以即时使用。这不仅仅是数据传输;更是共享体验。”一位年轻的研究员,伊莱恩·里德博士问道:“但是利克里德博士,我们如何克服如此遥远距离固有的延迟和可靠性问题?一个真正的‘星际’网络会带来巨大的工程挑战。”
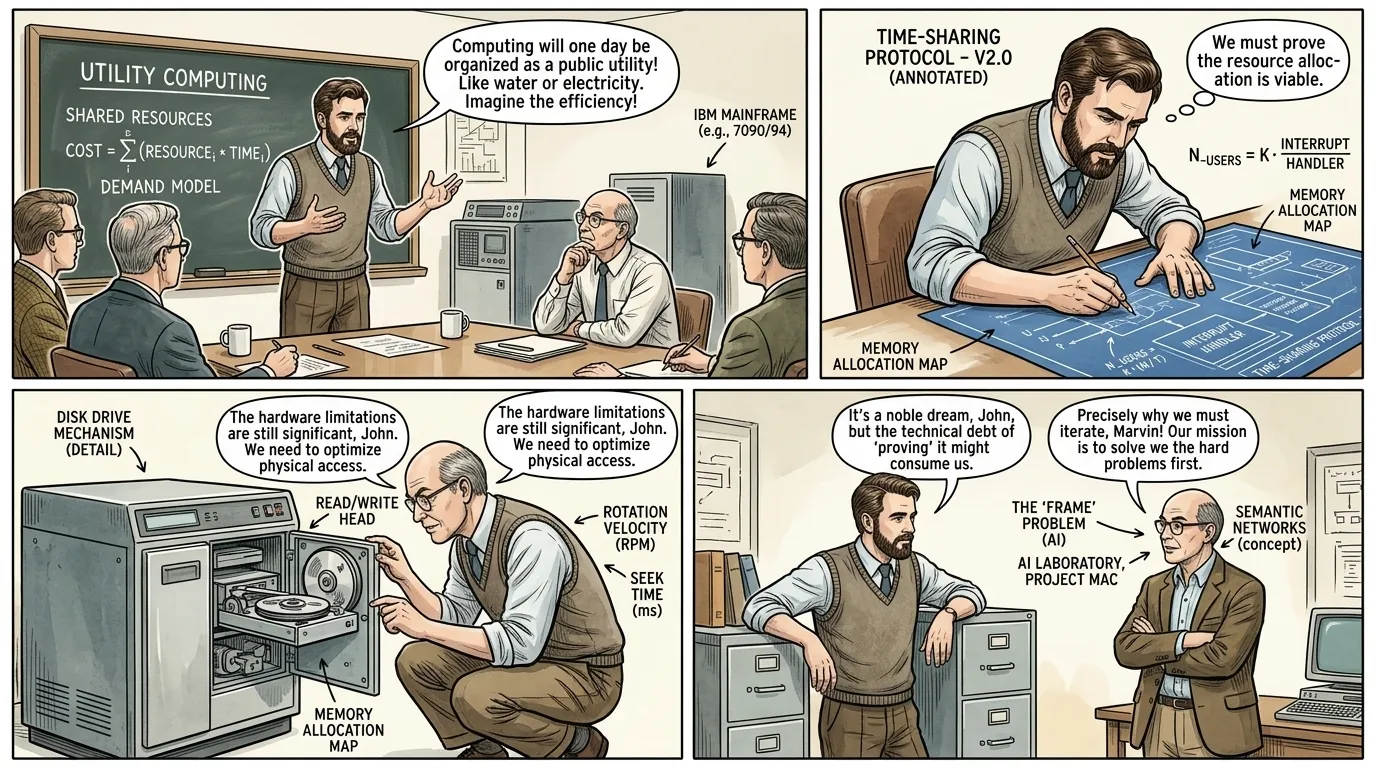
与利克里德的网络愿景并行,人工智能和计算机科学领域的另一位奠基人约翰·麦卡锡,倡导了“效用计算”的理念。这一概念从根本上改变了计算的经济模式,从昂贵的专用硬件转向了共享的、按量计费的服务。 “效用计算的论点很有说服力,约翰,”人工智能领域的另一位先驱马文·明斯基在一次部门会议上指出,“但要说服机构放弃对其专用机器的控制,将他们的关键操作委托给共享基础设施,将是一个巨大的心理和技术障碍。”约翰·麦卡锡,一个目光专注、胡须整洁的男人,回答道:“确实如此,马文。但规模经济是不可否认的。各个部门或公司只需购买他们所消耗的处理时间和存储空间,而不是投资于未充分利用的硬件。这种转变是从拥有基础设施到订阅服务。它使得访问比任何单一实体所能负担的更强大得多的系统成为可能。”
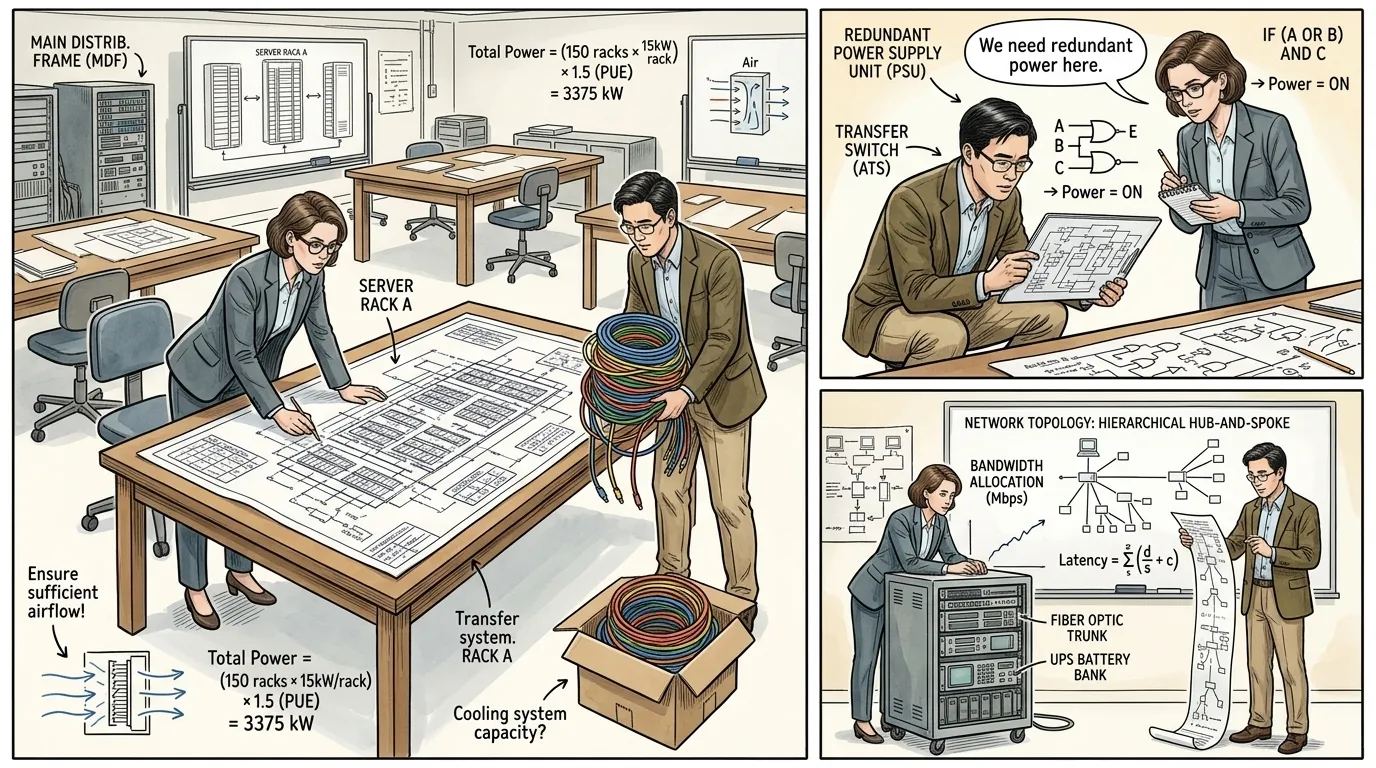
网络访问和公用计算的远见卓识面临着巨大的实际障碍。要创建一个真正健壮、可扩展和安全的系统,需要在数据中心设计、网络协议以及能够虚拟化和管理大量资源的复杂软件方面取得突破。 “管理数千台机器上的数据,并确保其完整性和可用性,其纯粹的复杂性令人望而却步,”系统架构师莎拉·詹金斯博士在二十世纪九十年代末审查新数据中心蓝图时评论道,“我们如何将数据的物理位置从用户那里抽象出来?我们如何确保冗余而又不至于成本过高,以及在不影响性能的情况下进行扩展?这是一种微妙的平衡。”她的同事大卫·陈回应道:“确实如此,莎拉。早期的尝试常常在单点故障上挣扎。突破将来自于真正的分布式架构,数据不仅仅是集中存储,而是复制到多个独立的节点上。这需要复杂的分布式文件系统和对象存储协议,而这些在利克莱德或麦卡锡的时代是不存在的。”
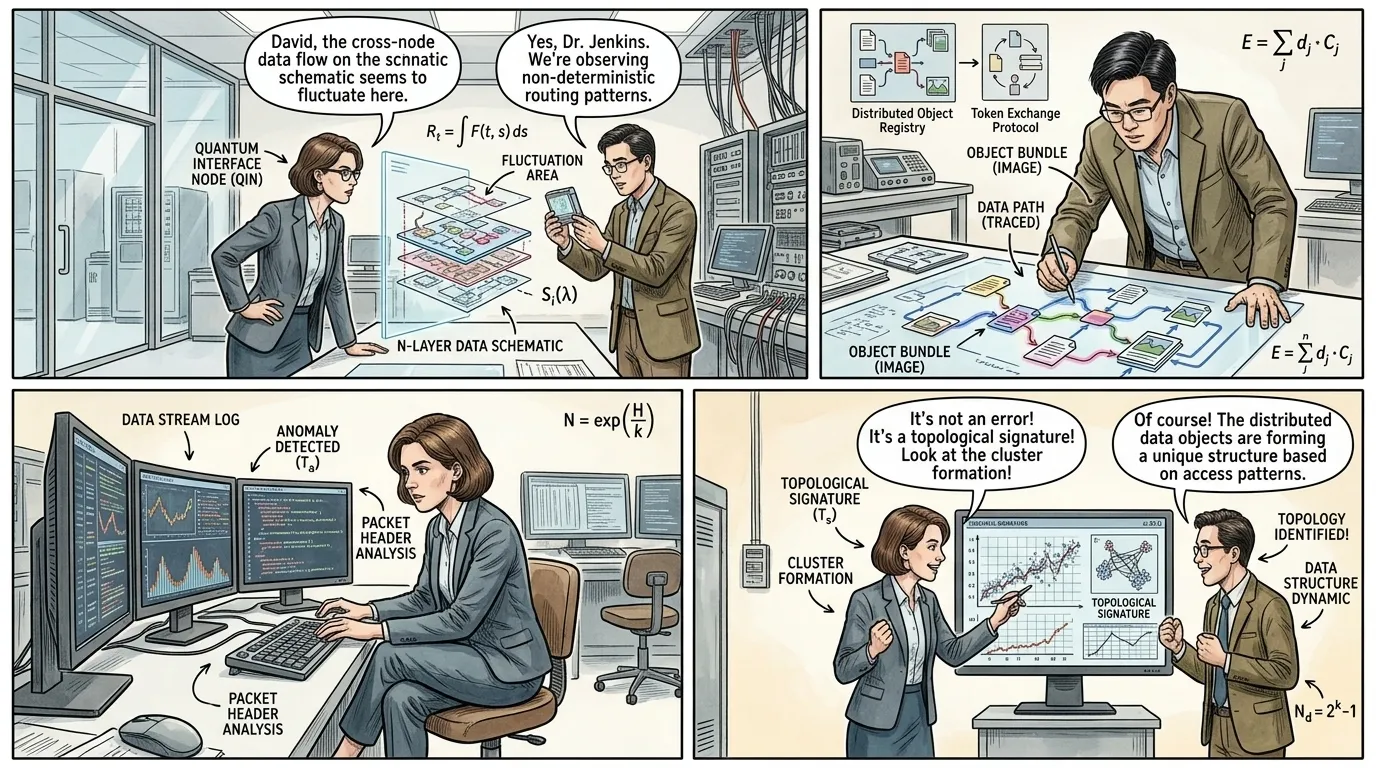
现代云存储得以实现的关键技术突破,在于可扩展对象存储系统的发展。与传统将数据组织在分层文件夹中的文件系统不同,对象存储将数据视为独立的单元,每个单元都有唯一的标识符和元数据,并分布在一个庞大的服务器网络中。 “有了对象存储,”陈向詹金斯解释道,同时在全息示意图上描绘着路径,“每一份数据——一份文档、一张图片、一段视频——都变成了一个‘对象’。这个对象不与特定的服务器,甚至不与特定的磁盘绑定。它被复制并分布在多个数据中心,这意味着即使一台服务器发生故障,数据仍然可用。这是我们韧性的核心。”詹金斯点点头:“抽象层在这里至关重要。用户不需要知道他们的数据存储在哪里;他们只需请求,系统就会智能地检索最近、最可用的副本。这是利克莱德普遍访问的实际实现,建立在分布式冗余和弹性的基础之上。”
二十一世纪初,概念性的愿景和技术突破汇聚成切实的服务。亚马逊网络服务(AWS)于二零零六年推出了其简单存储服务(S3),向公众提供高度可扩展、可靠且经济高效的对象存储解决方案,有效地普及了对大规模计算基础设施的访问。 “这具有里程碑意义!”首席工程师安雅·夏尔马在S3发布后的汇报会上,看着屏幕上显示的用量统计数据惊呼道,“采用率超出了我们所有的预测。从初创公司到大型企业,各种业务都在接受这种模式。他们不再需要配置自己的存储硬件;他们只需按使用量付费。”她的同事马克·奥尔森补充道:“确实如此,安雅。我们完全实现了利克莱德和麦卡锡所梦想的‘资源池化’和‘抽象化’的愿景。通过将海量存储作为一种公共事业提供,我们使无数组织摆脱了基础设施管理的负担,让他们能够专注于创新。S3体现了麦卡锡‘计算机可以作为公共事业组织’的理念,提供了前所未有的弹性存储水平。”
云存储的核心运作原理是分布式冗余和弹性。当用户上传数据时,数据会被分解成更小的块,加密,并复制到多个地理位置分散的服务器和数据中心。这确保了高可用性和抵御硬件故障的能力。 “你可以这样理解,”奥尔森解释道,他一边在平板电脑上演示简化的云架构,一边说,“当你上传一个文件时,它不会只保存到一个物理磁盘上。相反,我们的系统会智能地复制它——有时是多次——并将这些副本分发到不同的服务器,甚至在不同的区域。这种分布式冗余就是为什么,如果一个数据中心下线,你的数据仍然可以从另一个数据中心访问。”沙尔马补充道,“这就是‘云’这个比喻真正生动起来的地方。它是一个庞大、相互连接的网络,资源可以按需灵活伸缩。用户体验到的是一个无缝、几乎无限的存储解决方案,完全与底层的物理基础设施解耦。这种弹性意味着你可以即时地增加或减少存储容量,而无需购买或管理任何硬件。”
云存储从根本上重塑了数字格局,实现了前所未有的协作、可扩展性和数据可访问性。从个人照片档案到全球企业数据库,“云”已成为现代信息时代无处不在的支柱,改变了我们创建、共享和使用数字内容的方式。 “其影响是巨大的,”沙尔马沉思道,他观察着一个显示各种云应用程序的多面板显示器。“从全球媒体流媒体服务,到共享海量数据集以实现协作突破的科研人员,再到备份日常记忆的普通人——这一切都依赖于这种分布式架构。这不再是关于拥有数据,而是关于访问、管理和利用数据的力量。”奥尔森总结道:“确实如此。云存储开创了一个前所未有的数字自由和创新时代。它是为我们互联世界提供动力的无形公用事业,是普遍访问和共享计算资源这一持久愿景的证明。”