Machine Learning System — 用中文阅读
故事标题目前仍是英文,正文是中文。
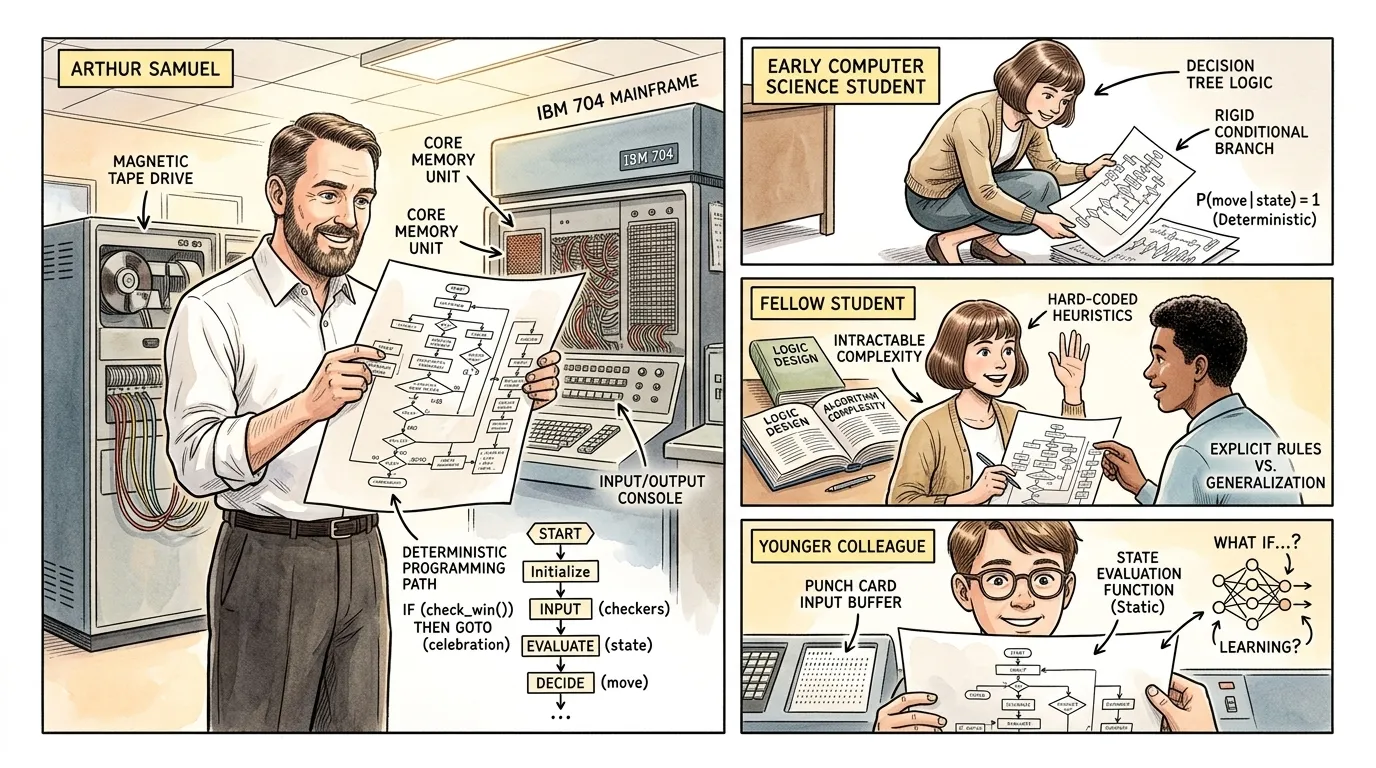
在机器学习出现之前,计算机是严格的逻辑机器,精确地执行编程指令。它们的强大之处在于快速计算和确定性输出,但这种僵硬也是它们的根本局限。对于需要适应性、模式识别或细致决策的任务,传统编程举步维艰,需要对每一种可能的情况进行详尽且往往不可能的规则枚举。
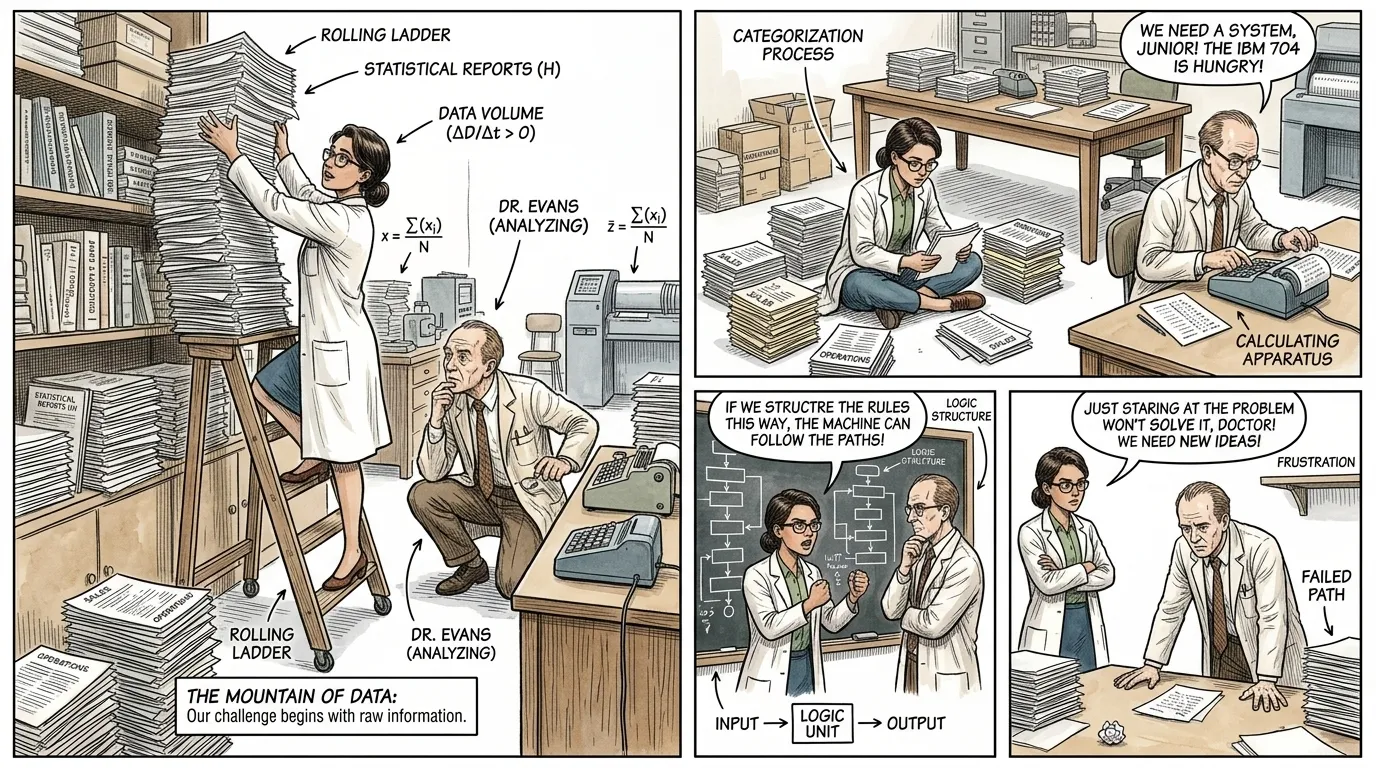
二十世纪中叶,数据呈爆炸式增长,远远超出了人类手动分析和明确规则定义的能力。人类可以毫不费力地识别人脸、理解语音并根据细微线索预测趋势,但要编程让计算机复制这种直觉却异常困难。每一个模式、每一个例外、每一个决策路径都必须经过精心编码,这使得许多复杂问题对于确定性系统来说变得难以处理。 “一位年轻的研究员,一位扎着深色马尾辫、戴着眼镜的女士,身穿一九五零年代的专业实验服,她指着一堆高耸的打印统计报告,语气坚定。她转向一位资深男性研究员,他头发稀疏,呈棕色,也穿着类似的实验服,说道:‘埃文斯博士,如此庞大的数据量让我们不堪重负。我们需要一种不仅能计算,还能学习泛化的东西,就像孩子从几个例子中掌握新概念一样。’”
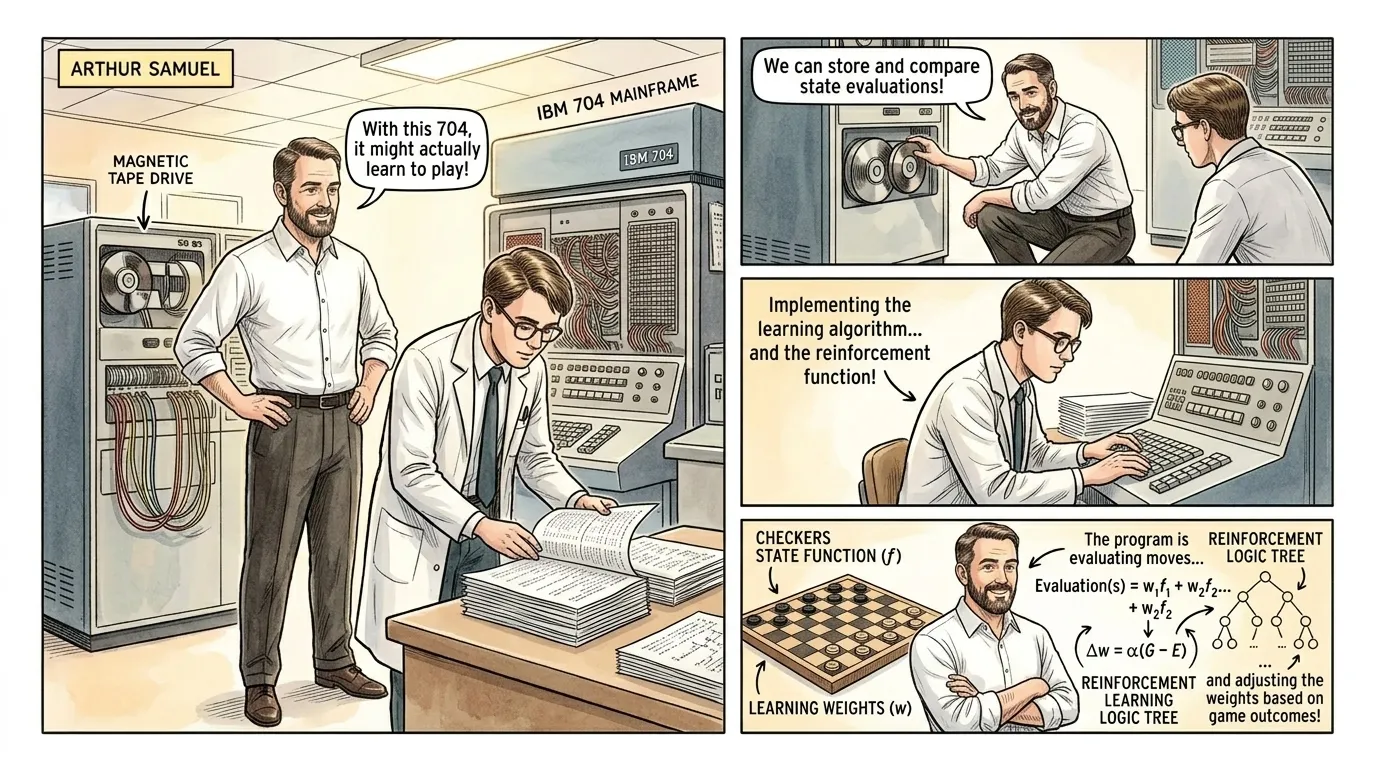
一九五九年,IBM 研究员亚瑟·塞缪尔取得了突破性进展。他没有为计算机编程所有可能的跳棋走法和反制走法,而是设想了一个可以通过与自己对弈来学习的程序。他的目标是创建一个能够评估棋盘状态、做出走法,并且最重要的是,通过重复经验改进其策略的系统,这标志着与纯粹确定性计算的明确背离。 “亚瑟·塞缪尔,一位四十多岁、自信的男士,留着修剪整齐的胡须,身穿笔挺的白衬衫和深色长裤,站在一台大型 IBM 七零四型主机旁,主机的面板闪烁着光芒。他看着一位同事,一位戴着眼镜的年轻男士正在仔细研究打印输出。塞缪尔平静而坚定地说道:‘挑战不仅仅是赢得一场比赛。而是要制造一台能够改进其比赛的机器。我们必须教会它评估、适应,而不仅仅是遵循预设的规则。’”
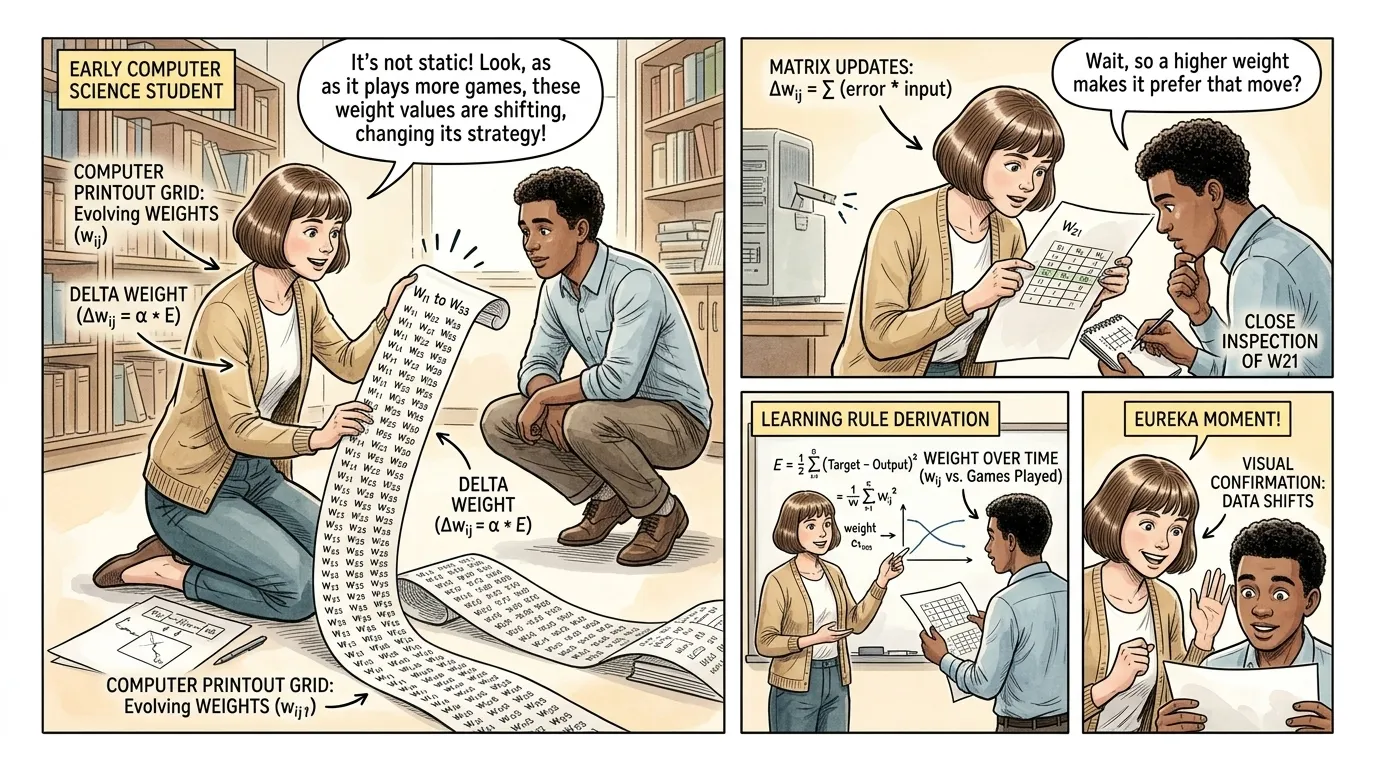
塞缪尔的程序通过一个“评估函数”进行学习,该函数根据棋子数量、移动性、王牌优势等各种特征,为不同的棋盘配置分配一个数值分数。至关重要的是,该程序在数千局游戏中调整了与这些特征相关的“权重”。如果一步棋导致胜利,则对促成胜利的特征的权重进行加强;如果导致失败,则削弱这些权重。这种迭代式的自我修正就是机器学习的起源。 “一位早期的计算机科学学生,一位留着短波波头、神情专注、穿着简单开衫的年轻女性,指着一份显示程序不断演变的‘权重’的打印件。她向一位同学解释道:‘看到这里了吗?经过数千局游戏后,程序不再需要明确的人工指令来指导每一步棋。它通过调整这些数值权重,学会了哪些棋盘状态更有价值。这就像它正在发展自己的直觉一样。’”
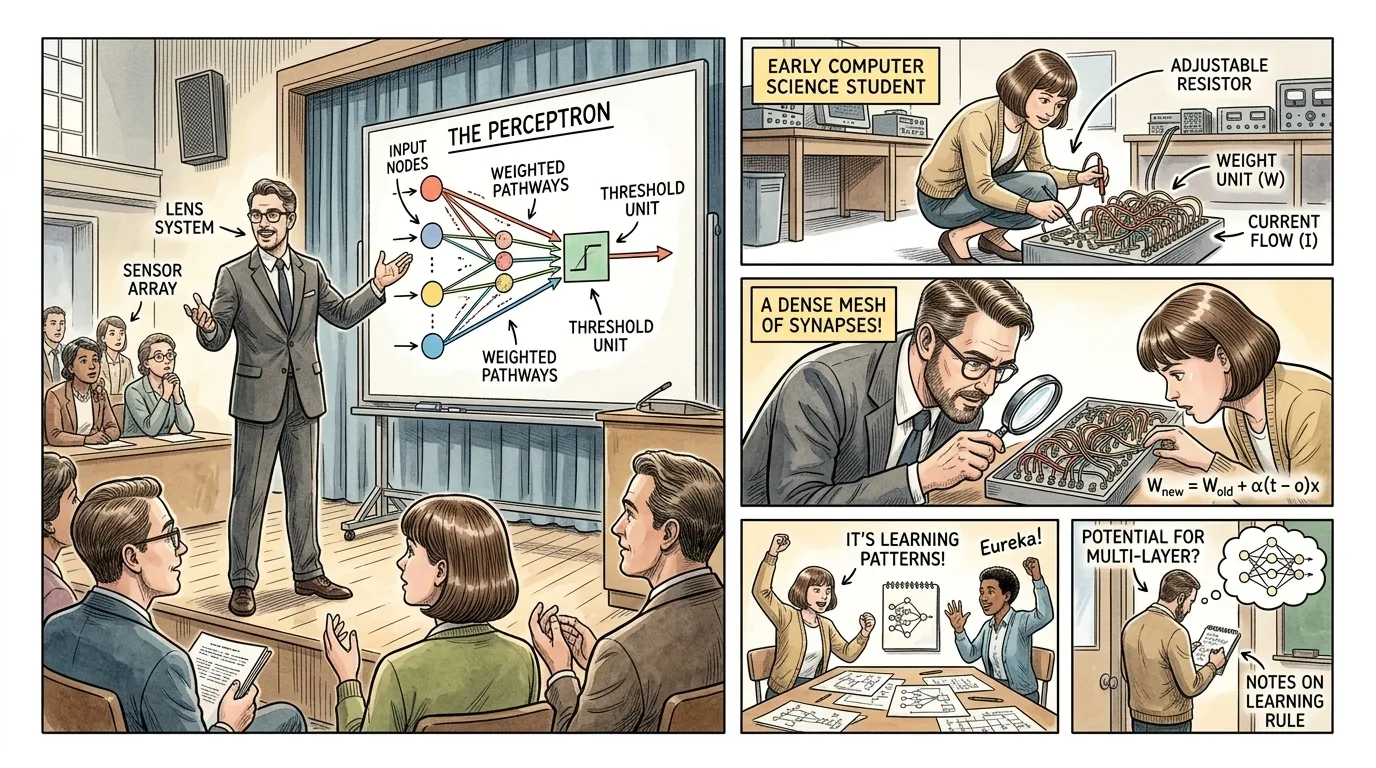
与此同时,弗兰克·罗森布拉特受生物大脑的启发,于一九五七年开发了感知器。这是一种用于简单神经网络的算法,能够学习对模式进行分类。它由连接到一个输出节点的输入节点组成,每个连接都有一个可调节的“权重”。感知器通过处理输入模式、将其输出与所需结果进行比较,然后迭代调整这些权重以减少误差来学习,模仿了神经元的塑性。 “弗兰克·罗森布拉特,一个魅力十足的男人,留着深色后梳的头发,穿着西装,戴着眼镜,正热情洋溢地指着一张大图表。他对一群专注的同事说:‘这不仅仅是计算;这是试图模拟基本学习。感知器向我们展示,机器可以调整其内部连接,即其“突触权重”,以区分不同的输入。它自己做出决定,从错误中学习,以完善其内部路径。’”
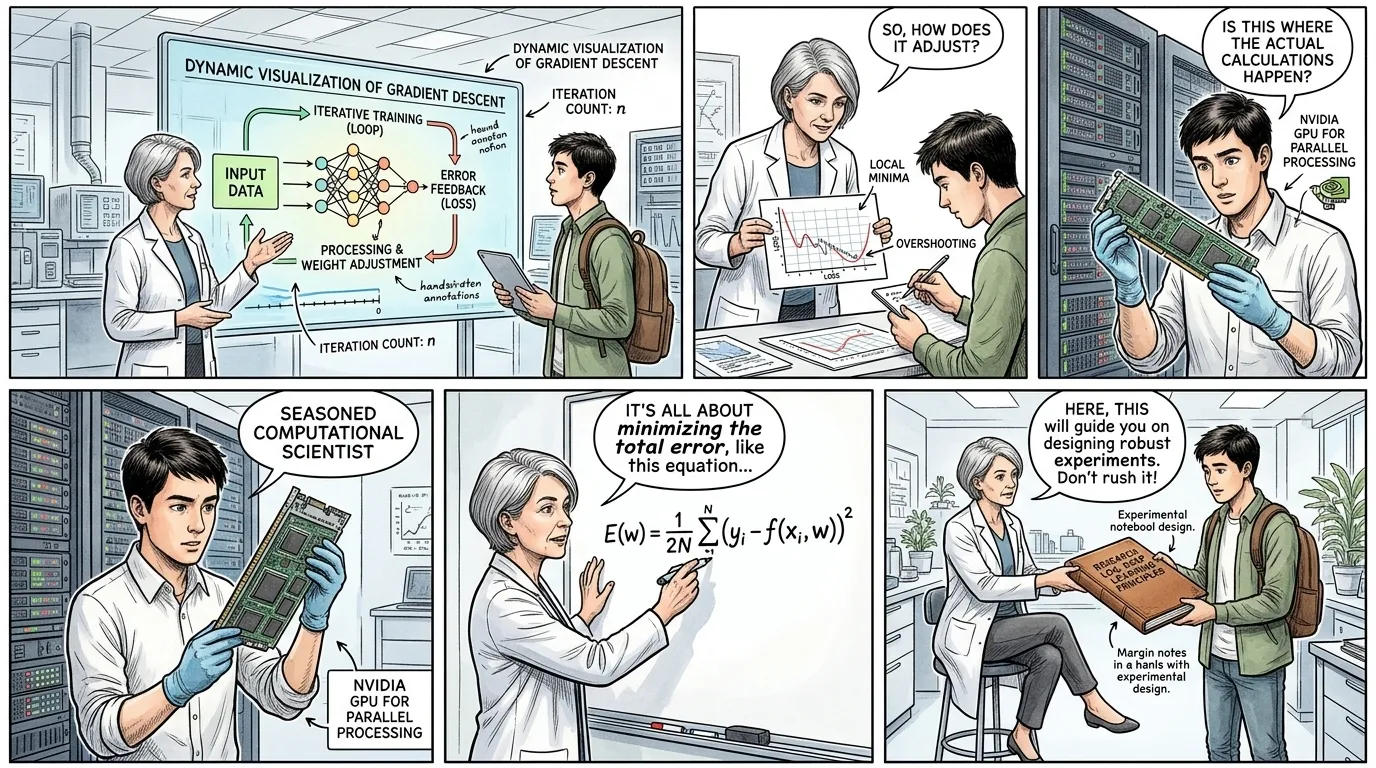
贯穿这些早期工作的共同主线是“迭代训练循环”。无论具体的算法或任务是什么,其基本机制都涉及一个重复的循环:模型处理输入数据以做出预测;将此预测与真实结果进行比较,生成一个误差信号;然后,此误差驱动模型内部参数(权重、偏差)的调整。这种持续的改进使得系统能够逐步提高其性能,并“学习”数据中复杂的关联。 一位经验丰富的计算科学家,一位留着实用短灰发、身穿实验服的女士,指着现代数据实验室大屏幕上一个动态的可视化界面,向一位来访的研究生解释道:“这个可视化展示了核心原理。系统不仅仅是在计算;它还在不断地自我修正。每个循环,它都会变得好一点点,根据反馈完善其理解。这就是训练循环的精髓。”
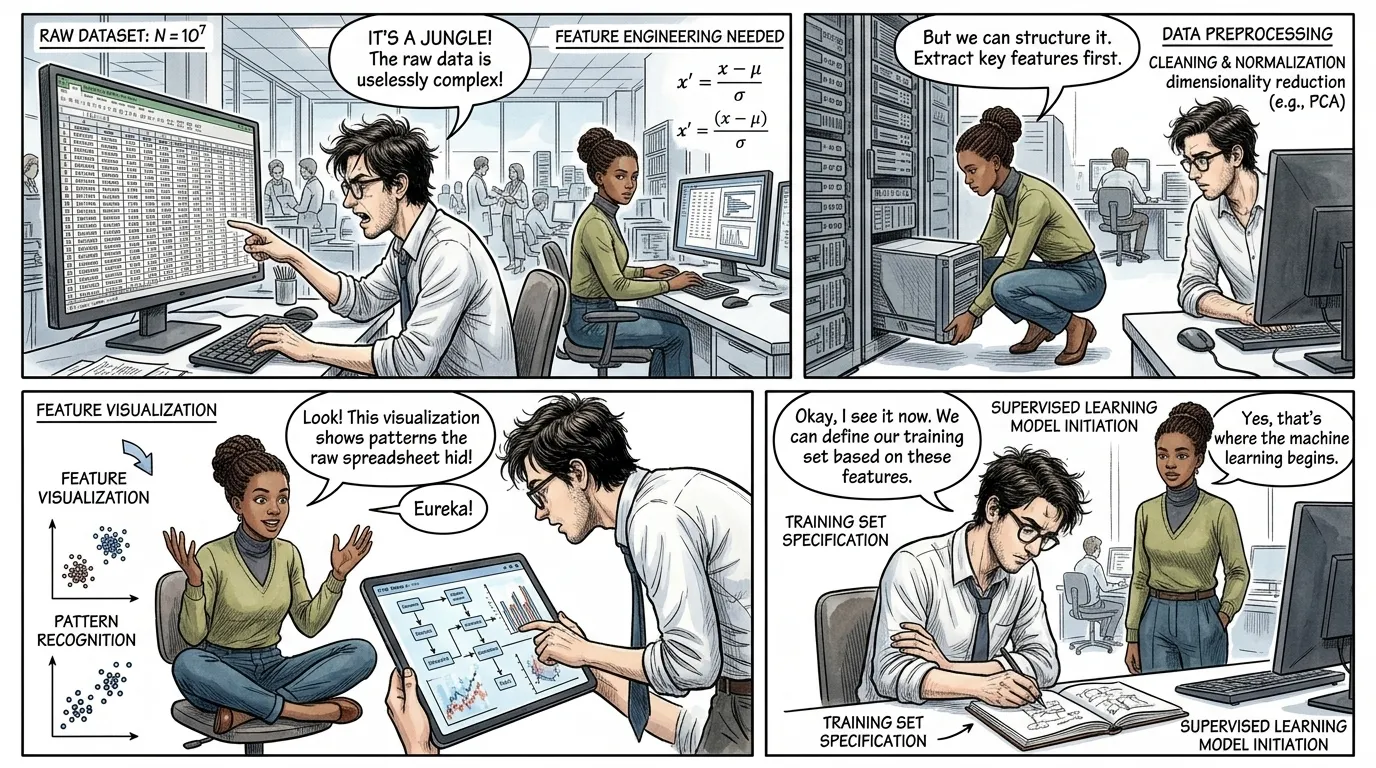
尽管学习机器前景广阔,但早期系统通常需要投入大量人力进行“特征工程”。数据科学家必须细致地识别、提取原始数据中的相关特征,并将其转换为适合模型的格式。例如,对图像进行分类需要人工定义“边缘检测器”或“角点检测器”等特征。这种手动预处理是一个瓶颈,限制了学习过程的复杂性和自主性。 一位沮丧的数据分析师,一个头发蓬乱、戴着眼镜的年轻人,不耐烦地敲击着显示器上复杂的原始传感器数据电子表格。他转向他的同事,一位在实验室环境中、扎着整齐发髻的专注女性,惊呼道:“我们花在手动提取和塑造这些‘特征’上的时间,比机器学习的时间还要多!正如伟大的物理学家理查德·费曼曾经观察到的,‘我无法创造的东西,我就不理解。’很长一段时间以来,我们不得不为我们的模型创造特征,但真正的理解将会在机器能够从原始数据本身创造自己的理解时到来。”
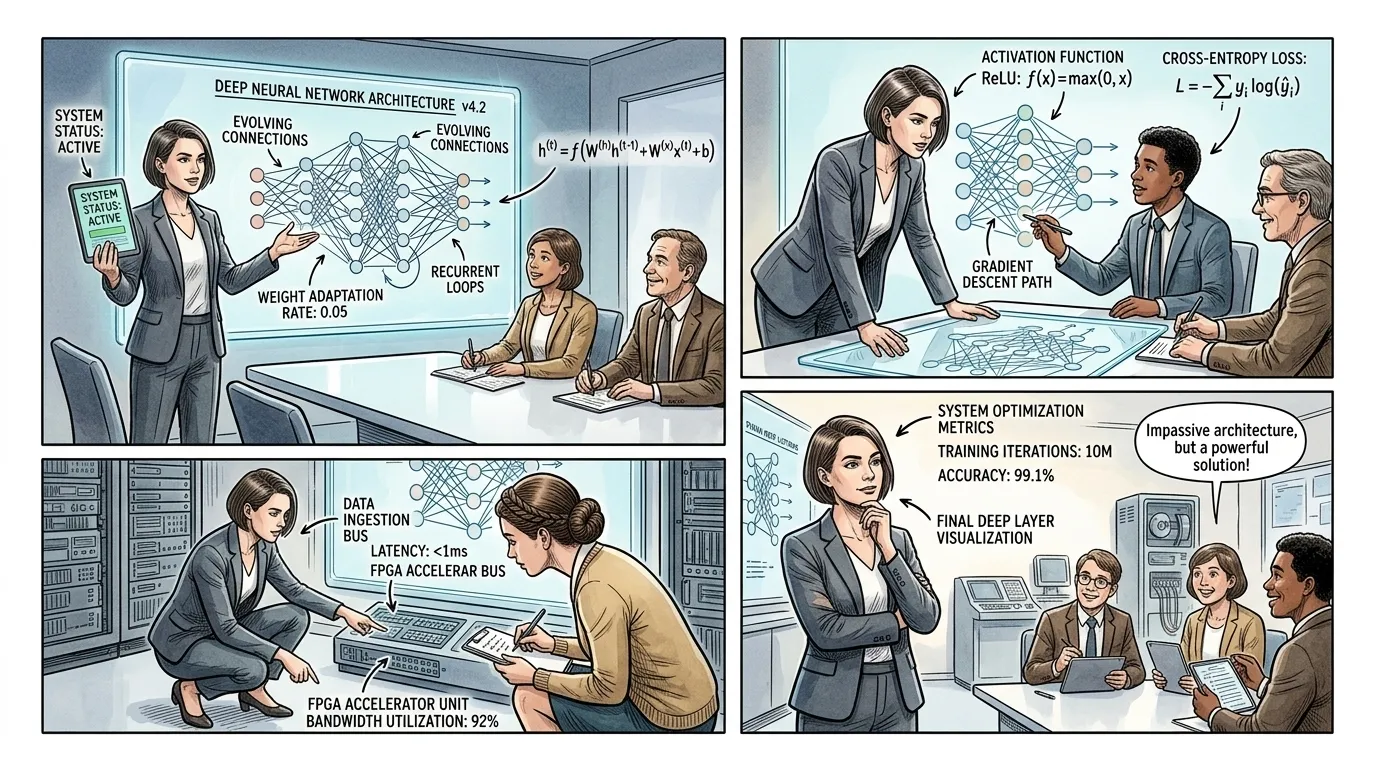
数十年的不懈研究,加上计算能力的指数级增长和海量数据集,最终催生了“深度学习”革命。受大脑分层处理的启发,多层神经网络作为一种范式转变应运而生。这些系统可以直接从原始数据中学习复杂的抽象特征,而无需明确的人工设计。每一层都将输入转化为日益复杂的表示,从而在广泛而多样的领域中实现了前所未有的泛化能力和准确性。 一位首席人工智能架构师,一位留着时尚现代短发、身穿干练西装外套的女士,站在一个大型透明显示屏前,屏幕上展示着一个动态演进的深度神经网络架构。她向一群高管解释道:“这个架构不仅仅是在处理;它还在发现。系统本身逐层从原始数据中学习最优表示。它真正让系统以早期研究人员梦寐以求的方式进行‘泛化’,从数据本身中学习,正如曾经所希望的那样。”她指向那些错综复杂的连接。
先进机器学习系统所释放出的强大能力,使其在几乎所有行业中得到了普遍采用。从为个性化在线体验提供支持的推荐引擎,到实现复杂的医疗诊断、欺诈检测和自动导航,机器学习已成为不可或缺的工具。它使组织能够从海量数据中获取可操作的洞察,自动化复杂任务,并创建以前只存在于科幻小说中的智能系统。 “一位项目经理,身着笔挺衬衫,正看着他的平板电脑,上面显示着一项智慧城市计划的实时分析数据。他向一位同事评论道:‘这项技术融入我们日常生活的速度真是惊人。就在十年前,这种水平的预测分析和自动化还是不可想象的。现在,它正在优化从交通流量到能源网格的一切。’”
如今,机器学习继续快速发展,推动着生成式人工智能、科学发现和人机交互领域的突破。然而,其变革力量也带来了深刻的伦理考量:算法偏见的可能性、模型可解释性的必要性、对就业的社会影响,以及负责任治理的至关重要性。从塞缪尔的跳棋程序到今天复杂的神经网络,这段历程证明了人类的聪明才智,为未来带来了巨大的希望,也带来了严峻的挑战。 一位伦理人工智能研究员,一位表情深思、深色头发中夹杂着银丝的女士,站在一个大型公共论坛前。她对听众说:“当我们拓展机器智能的边界时,我们必须同时深化我们对伦理框架的承诺。我们构建的智能必须是透明的、公平的、负责任的。我们最伟大的发明要求我们承担最重大的责任。”