Search Algorithm — 用中文阅读
故事标题目前仍是英文,正文是中文。
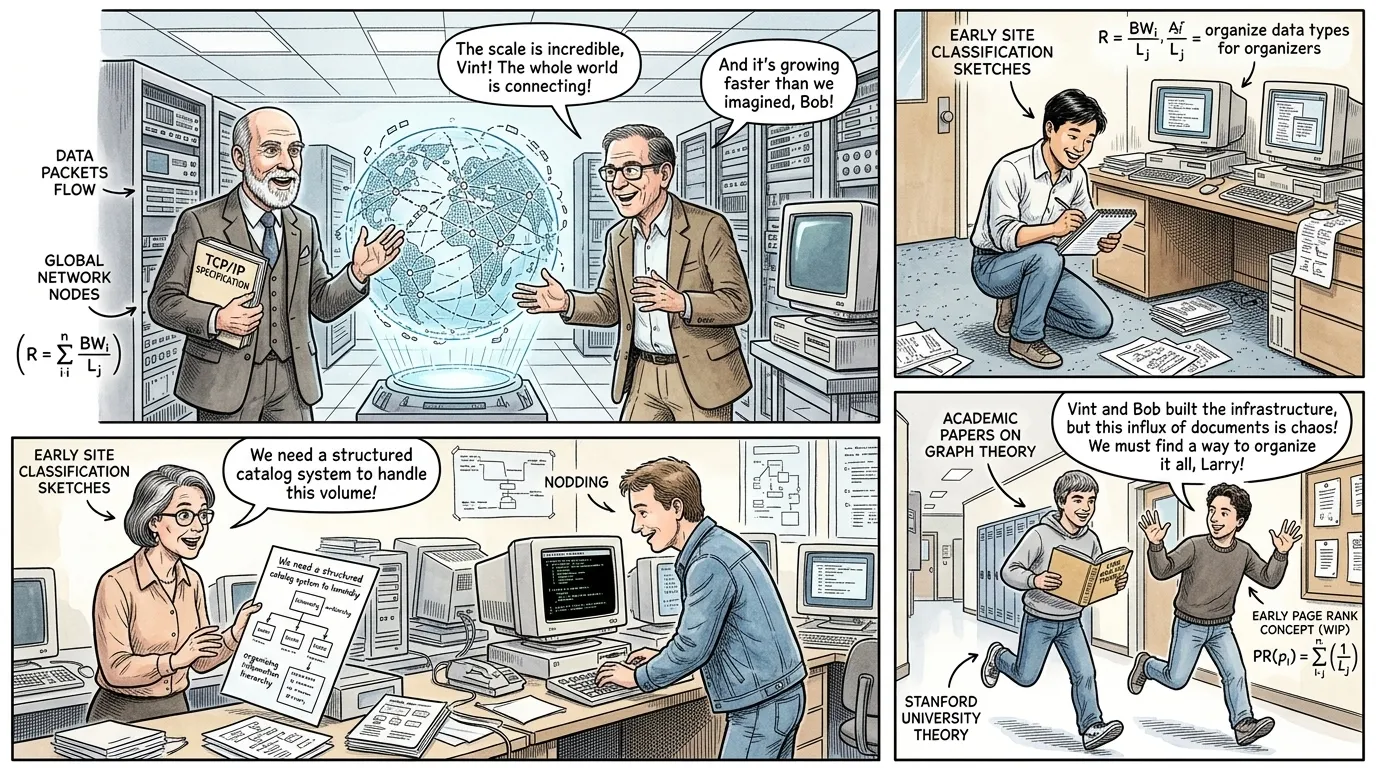
万维网的出现预示着一个前所未有的信息获取时代。然而,到了二十世纪九十年代中期,互联文档的数量从几千份激增到数百万份,一个新的关键问题浮现出来:如何在数字洪流中找到任何相关信息。早期的互联网先驱,包括TCP/IP协议的创建者文顿·瑟夫和罗伯特·卡恩,都明白连接计算机只是第一步;让其海量内容可被发现才是真正的前沿。如果没有一个强大的系统来组织和检索这些快速增长的数据,互联网就有可能变成一个无法使用、混乱不堪的图书馆。
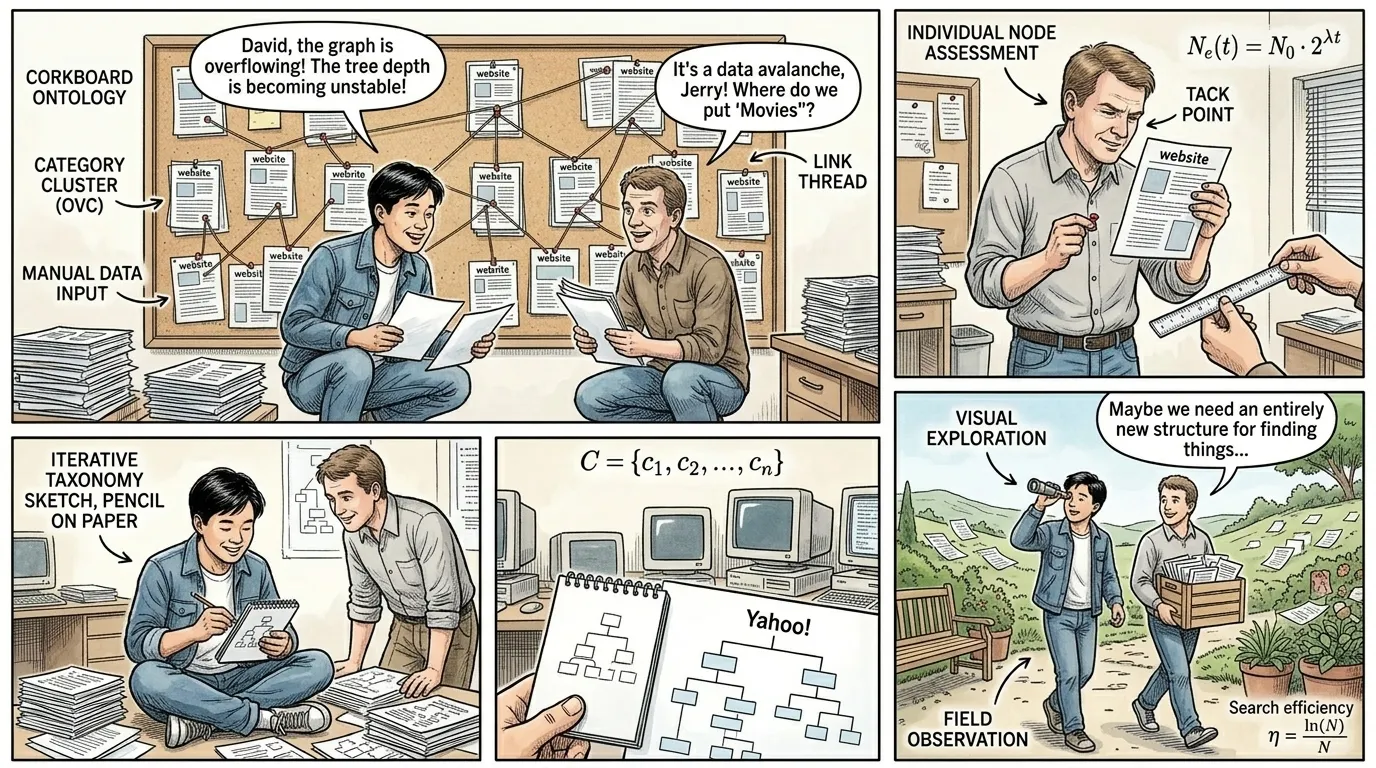
在复杂的搜索算法出现之前,在线查找信息的主要方法是通过人工整理的目录。像雅虎!这样的服务,由杨致远和大卫·费罗于一千九百九十四年创立,依靠人工编辑将网站分类到层级结构中。用户会通过“艺术 电影 类型”等类别逐层深入,以找到所需内容。尽管这是一项英勇的努力,但这种手动方法难以跟上网络指数级的增长。新网站出现的速度快于它们被索引的速度,而且人工整理的主观性常常导致不完整或有偏见的结果。数字宇宙扩张得太快,人类之手无法将其完全绘制出来。
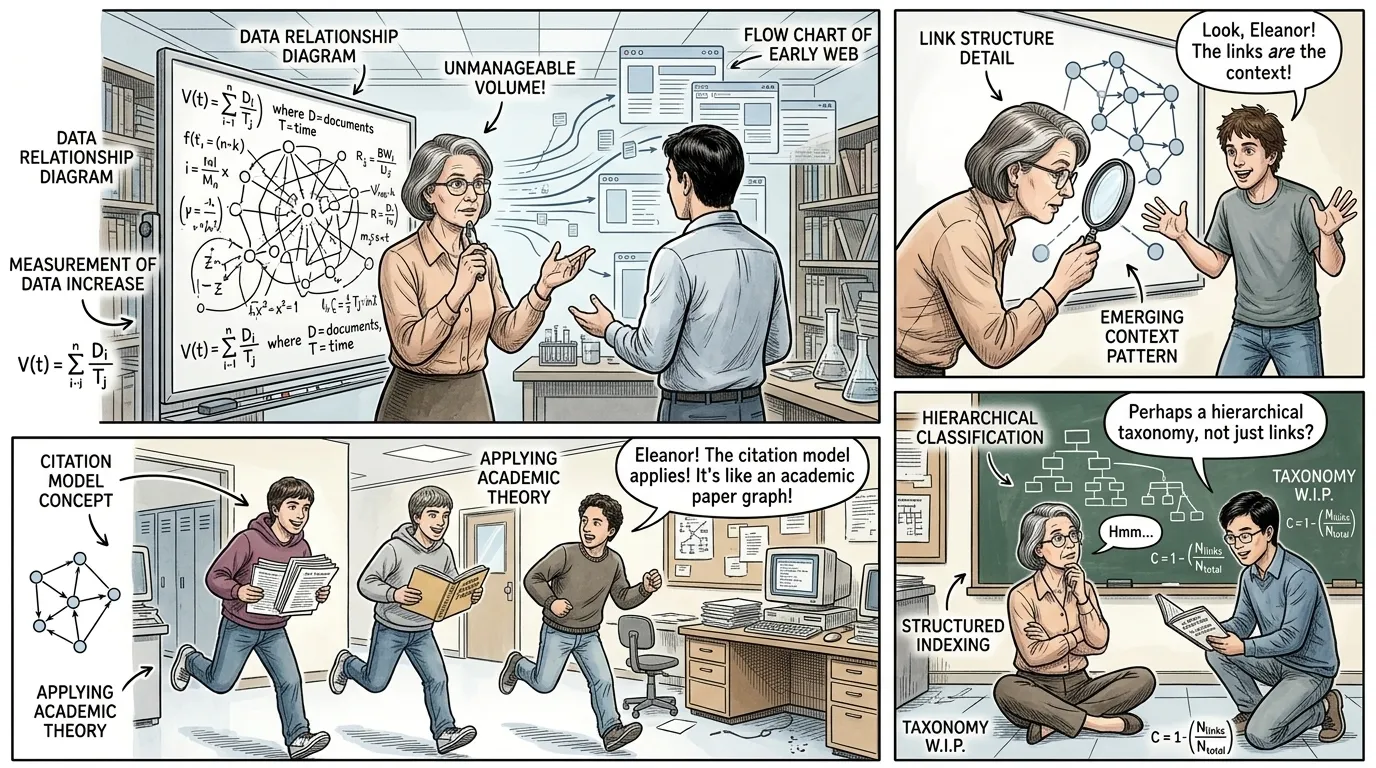
最根本的挑战是明确的:实现信息检索的自动化,以将用户查询与高度相关的文档进行匹配。早期超越简单关键词匹配的尝试,努力应对语言的歧义和海量数据。仅仅计算关键词很容易被操纵,导致不相关的“垃圾”结果。研究人员知道,真正有效的搜索不仅需要理解页面上有哪些词,还需要理解页面的内在价值及其与其他信息的关系。这项探索需要范式转变,从内容分析转向结构理解。 “埃莉诺·万斯博士,一位留着短发、棕色头发中夹杂着灰白发丝、穿着得体的衬衫和戴着眼镜的研究员,站在一块写满了数学方程式的白板前。她转向一位同事,神情沉思。“正如万尼瓦尔·布什早在 一九四五年所阐明的,‘现有索引系统的固有困难是巨大的。’他指的是科学论文,但这完美地描述了我们现在的数字困境。我们正被大量未经消化的数据所淹没。网络的增长速度超过了我们目前理解它的方法。””
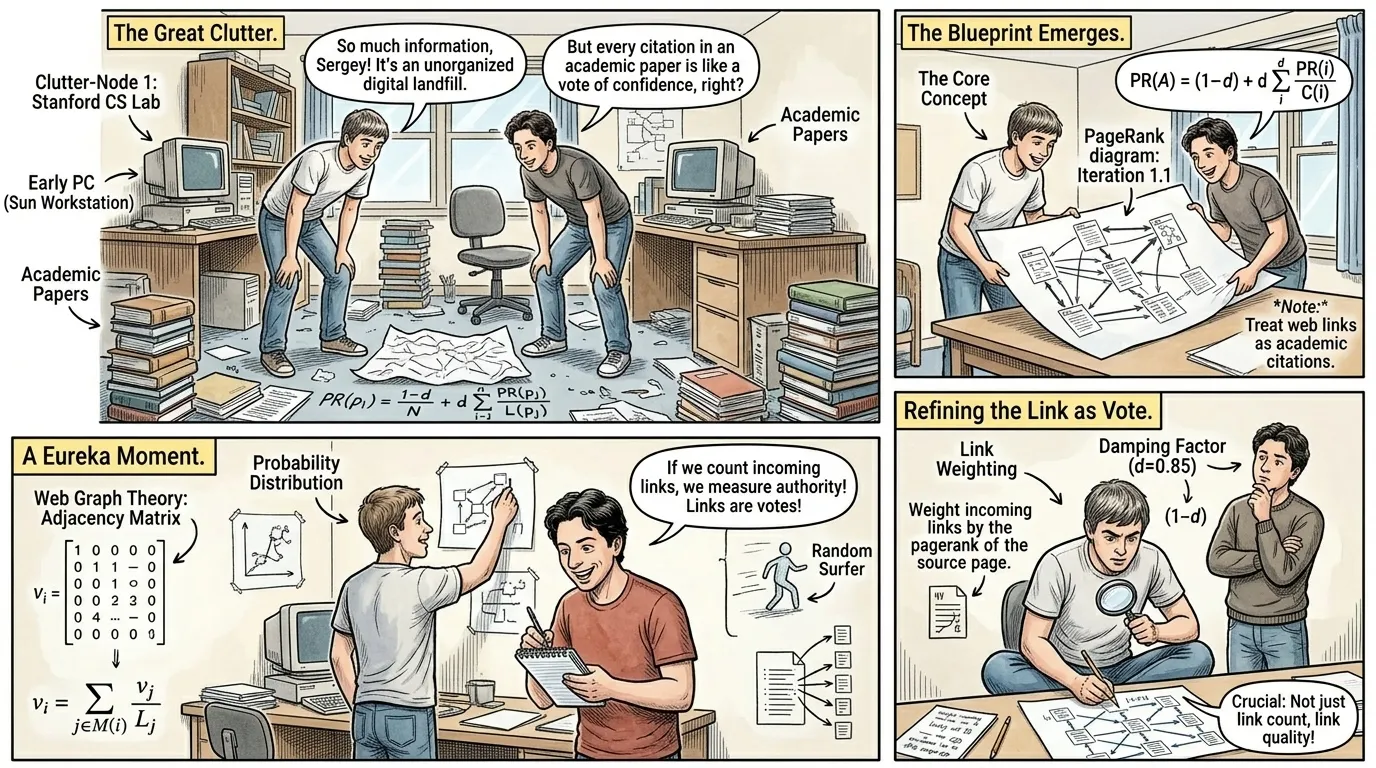
在二十世纪九十年代中期,斯坦福大学的两位博士生拉里·佩奇和谢尔盖·布林开始从一个全新的角度解决这个问题。他们没有仅仅关注网页中的内容,而是考虑了万维网本身的结构。他们的灵感来源于学术引用实践:一篇被许多其他重要论文引用的论文,其本身也很可能很重要。他们推断,同样的原则也可以应用于网页,其中从一个页面到另一个页面的链接可以被解释为“投票”的重要性。这种“引用分析”方法将成为他们革命性搜索引擎的基石。
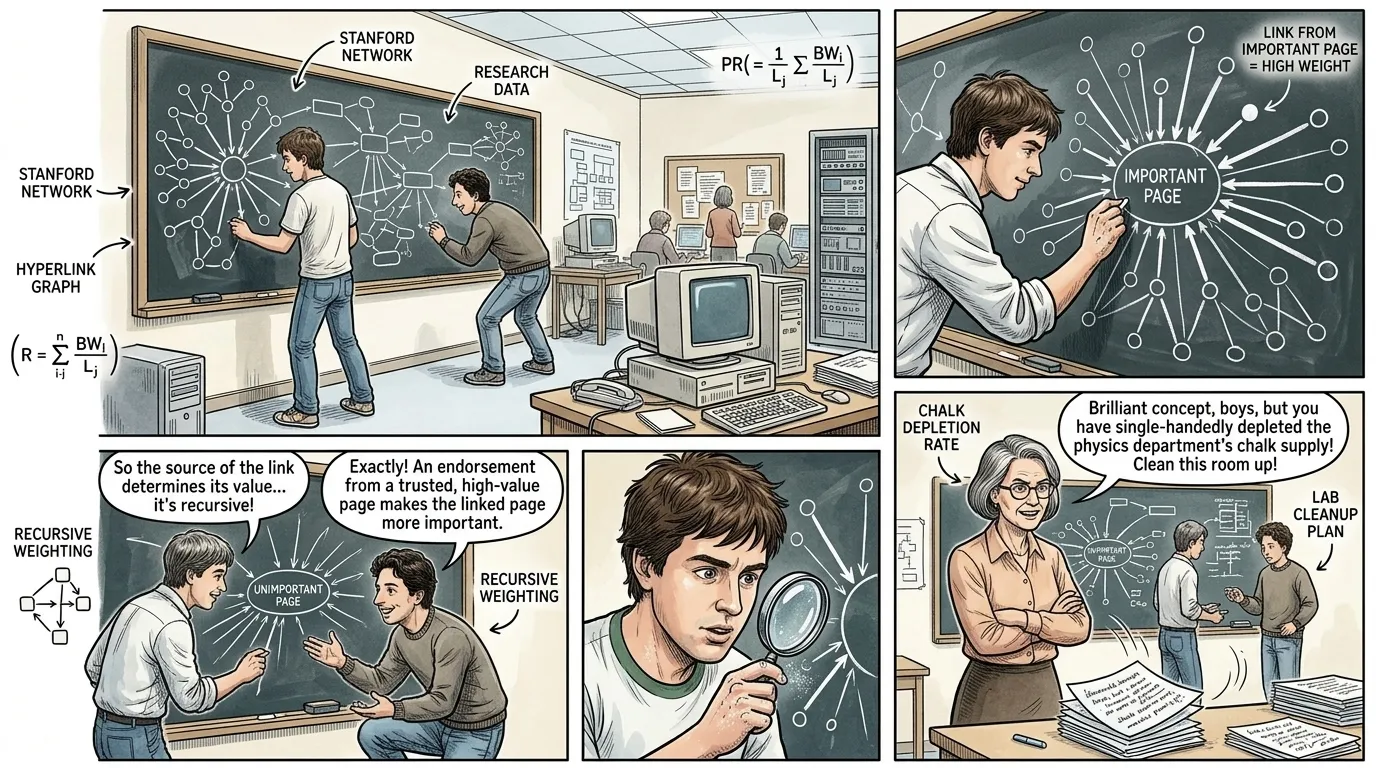
佩奇和布林的研究项目最初被称为“Backrub”,因为它分析指向特定网页的“反向链接”。他们早期的实验证实,简单的链接计数太容易被操纵。一个网页可能会积累许多低质量的链接,但仍然显得很重要。真正的突破来自于对这些链接进行加权:来自重要页面的链接应该比来自不重要页面的链接权重更高。这种递归思维——一个页面的重要性源于链接到它的页面的重要性——形成了后来被称为PageRank的核心概念,这个系统从根本上理解了网络的隐式层级。
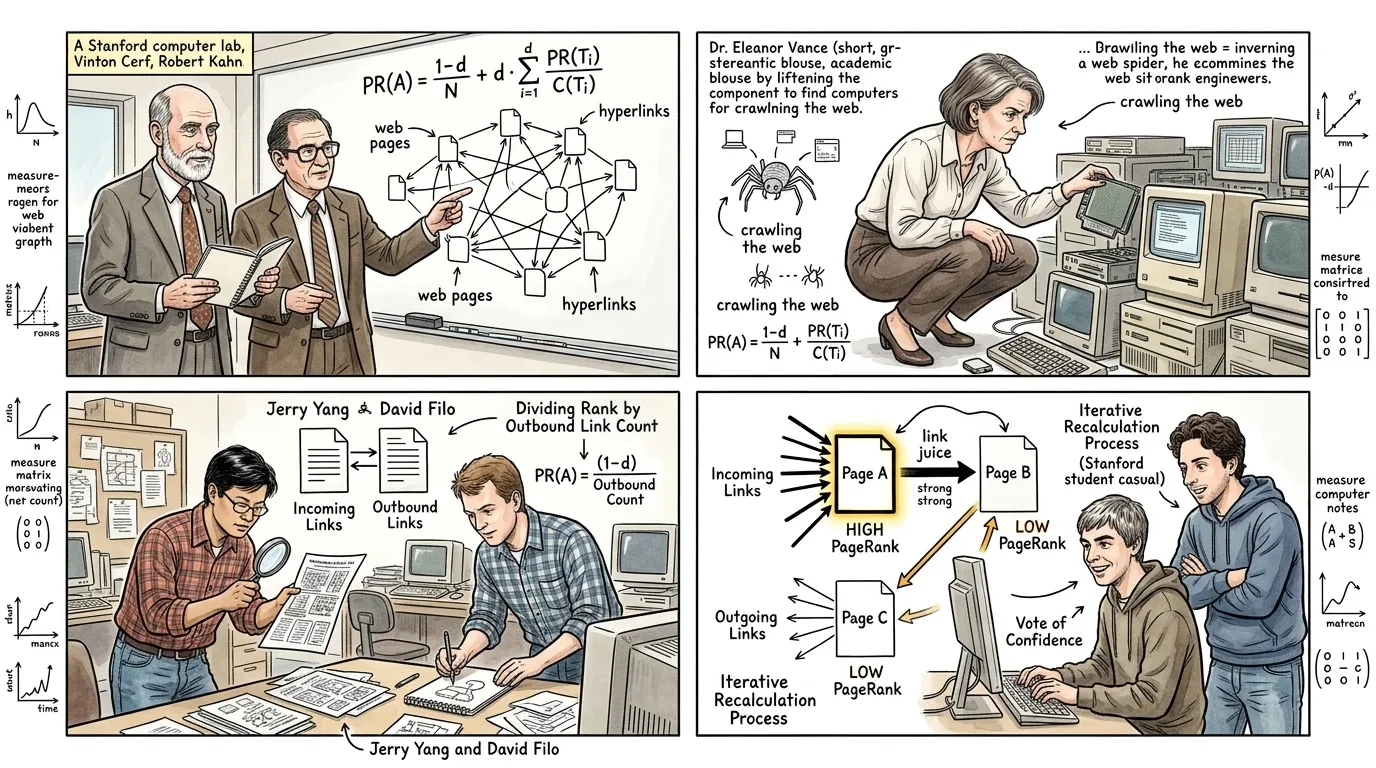
PageRank 算法以拉里·佩奇的名字命名,它为每个网页分配一个数值化的“重要性”分数。该算法基于这样一个前提:从页面 A 到页面 B 的链接代表着一种信任投票。至关重要的是,该投票的权重取决于页面 A 自身的 PageRank。PageRank 较高的页面会向其链接的页面分发更多的“链接汁”。此外,PageRank 还考虑了页面上的出站链接数量:如果页面 A 链接到许多页面,其“投票”就会在这些页面之间分配,从而减弱每个单独链接的影响。这种迭代过程,根据最新的网络拓扑结构不断重新计算分数,提供了一种衡量页面权威性的卓越有效方法。
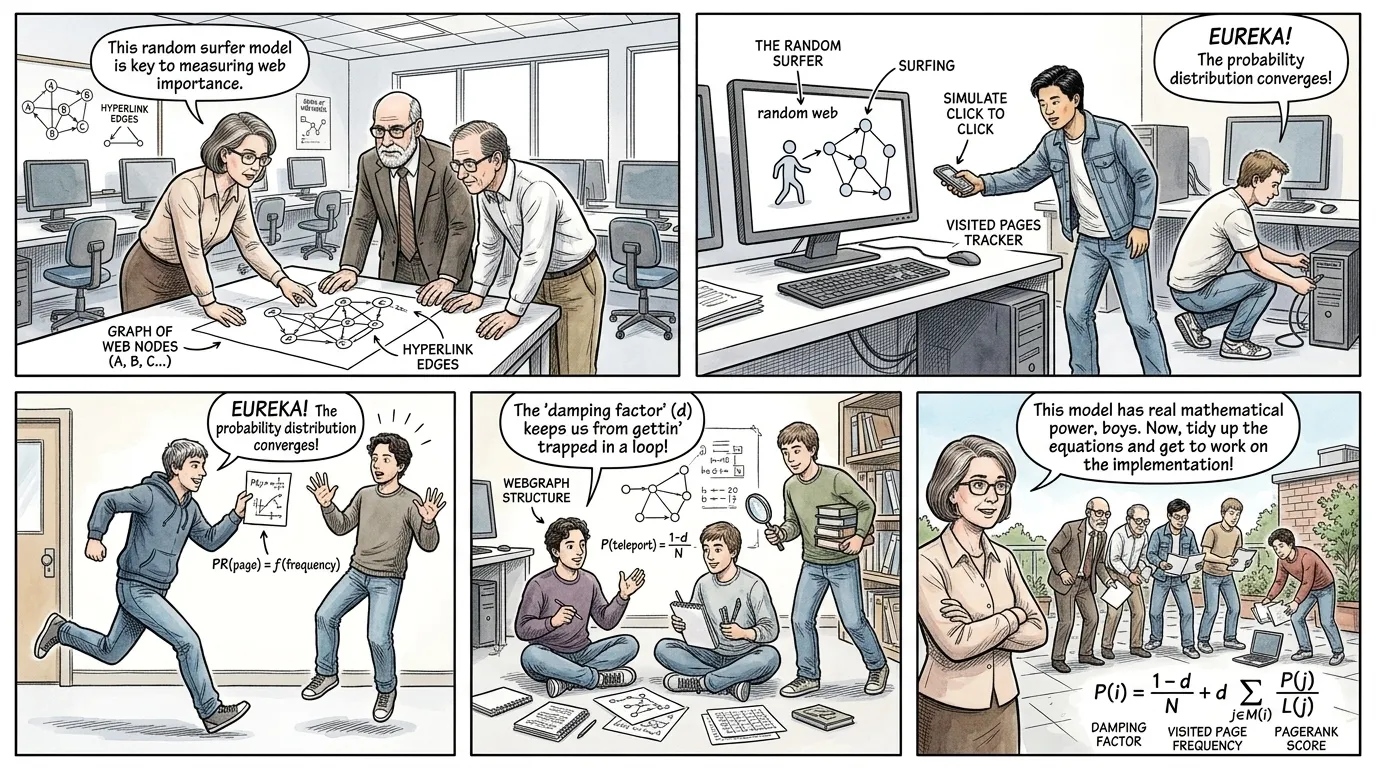
为了计算 PageRank,该算法采用了一个概念性的“随机冲浪者”模型。想象一个用户随机点击网页上的链接。在多次点击后,冲浪者停留在某个特定页面的概率就是它的 PageRank 分数。该算法还包含一个“阻尼系数”——一个很小的概率,即冲浪者不是点击链接,而是“瞬移”到一个随机的新页面。这可以防止死胡同,并确保所有页面,即使是没有入站链接的页面,也有机会被发现,尽管 PageRank 会非常低。这种复杂的数学模型将一个主观问题转化为一个可量化的问题,为网页排名提供了一个稳定且可扩展的解决方案。
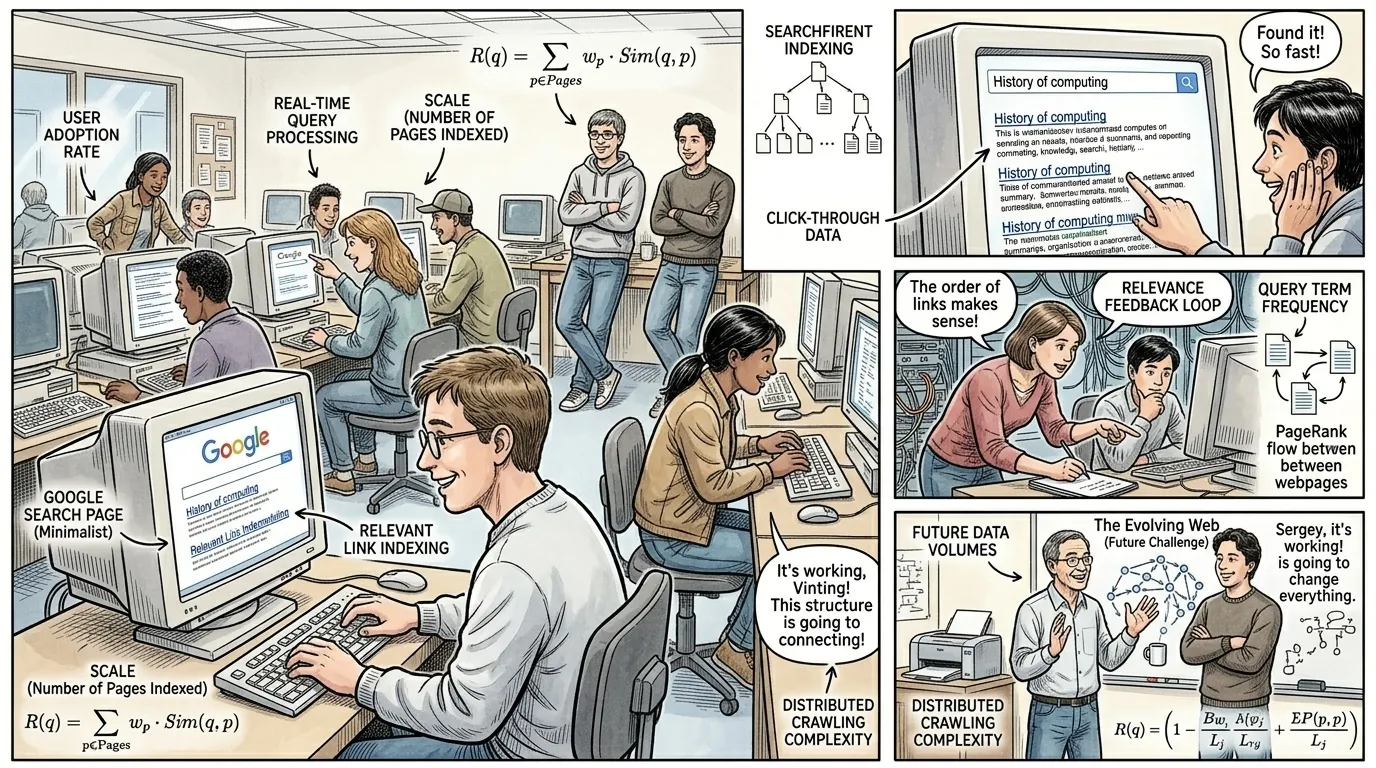
谷歌于一九九八年正式上线,其核心是PageRank算法。它最初的搜索结果明显优于竞争对手,以前所未有的速度提供了高度相关和权威的链接。用户很快就被谷歌吸引,因为它能够过滤掉日益增长的互联网上的噪音。这种快速的用户采纳巩固了谷歌作为领先搜索引擎的地位。然而,互联网持续发展,搜索的复杂性也随之增加。随着网络变得更加动态,用户行为也日益多样化,谷歌的算法必须不断调整并整合PageRank之外的新信号,以保持其相关性并打击日益复杂的操纵企图。
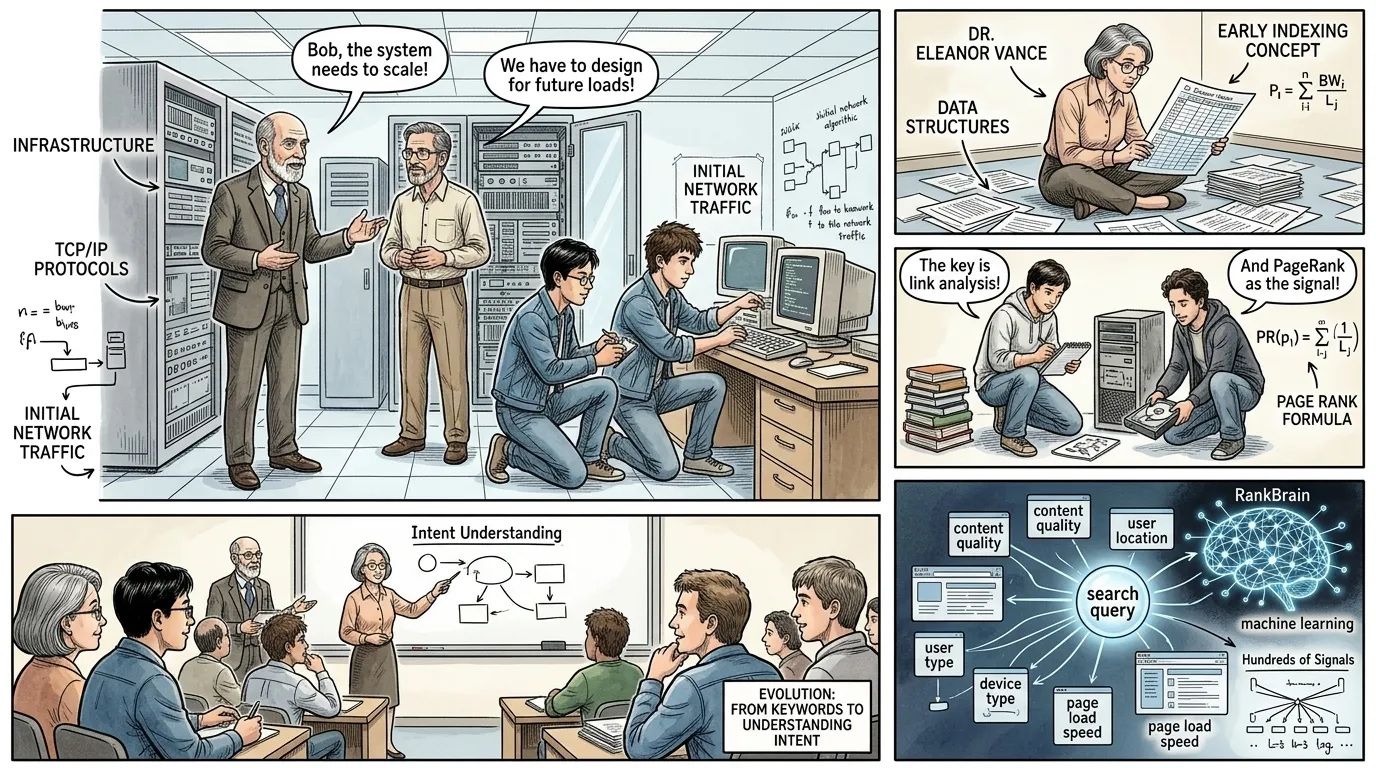
虽然PageRank仍然是一个基础元素,但现代搜索算法要复杂得多,它包含了数百种信号。这些信号包括内容质量、关键词使用、用户位置、搜索历史、设备类型、页面加载速度,以及越来越多地,复杂的机器学习和人工智能模型。谷歌的蜂鸟更新(二零一三年)标志着向语义搜索的转变,它理解查询的含义和上下文,而不仅仅是关键词。RankBrain(二零一五年)是一个由人工智能驱动的组件,它帮助解释模糊的查询,并提供更相关的结果,不断从用户互动中学习。今天的搜索算法不是一个单一的公式,而是一个动态的、多层次的系统,旨在理解意图并提供个性化、精确的信息。
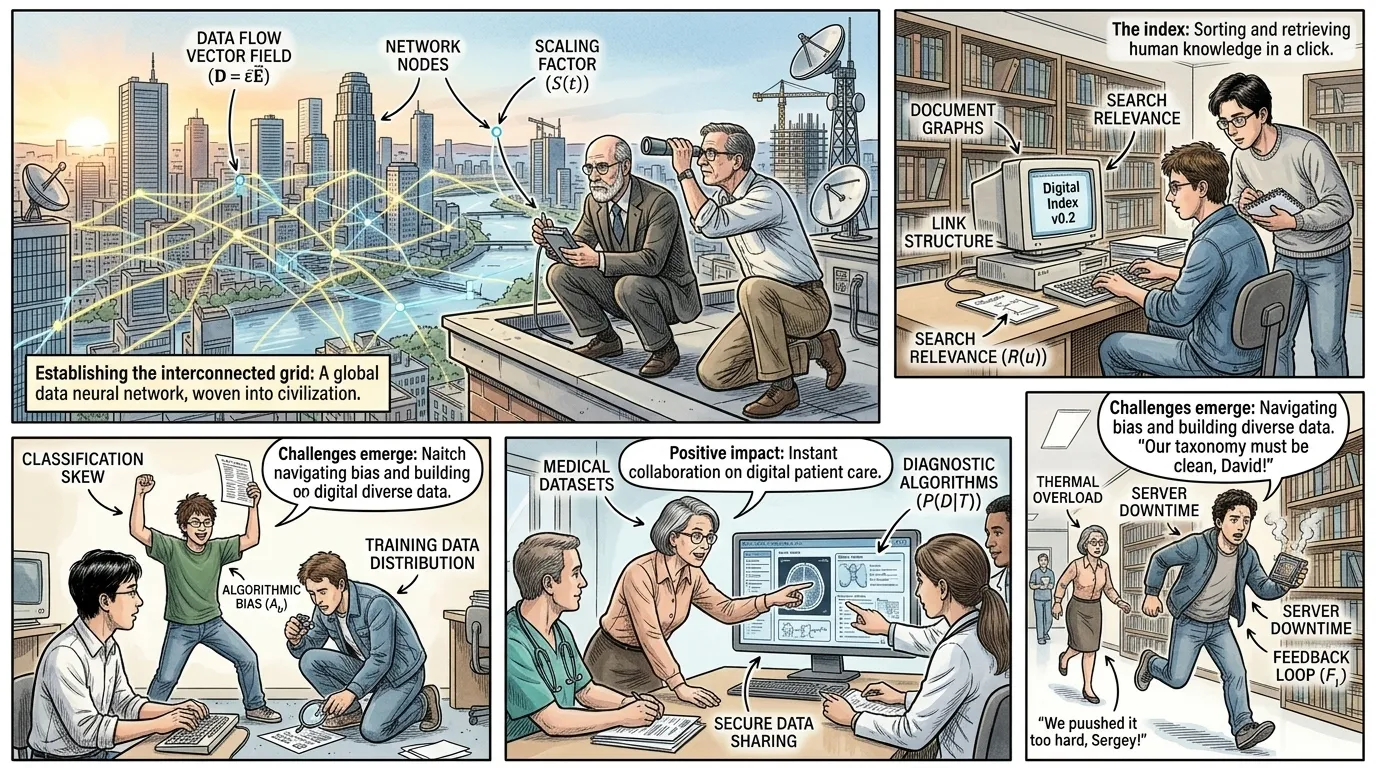
搜索算法深刻地重塑了人类文明,成为日常生活中无形的底层基础设施。它使信息获取民主化,让个人能够掌握以前仅限于图书馆和机构的知识。从电子商务和精准广告推动的经济增长,到新闻和学术研究的即时传播,其影响力无处不在。然而,这种力量也带来了挑战:过滤气泡的潜在形成、错误信息的传播以及算法偏见的伦理考量。搜索算法是人类在组织混乱方面的独创性证明,它将继续演进,塑造我们对世界的理解以及我们在这个广阔、不断扩展的数字版图中的位置。