Smart Speaker — 用中文阅读
故事标题目前仍是英文,正文是中文。
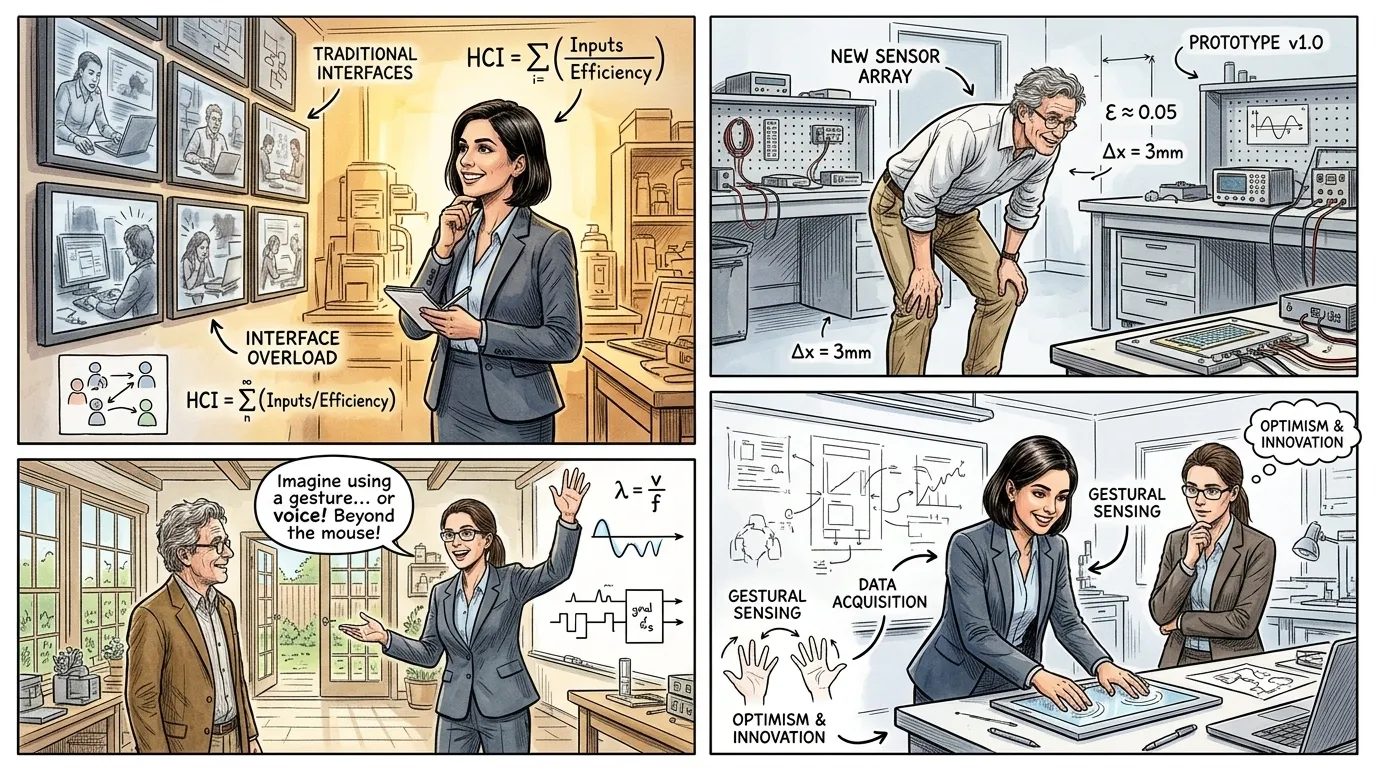
在智能音箱问世之前,人类与科技的互动主要局限于屏幕、键盘和按钮。获取信息或控制设备通常需要直接的物理接触,这打断了日常生活的自然流畅性。这种普遍存在的摩擦给寻求更直观界面的技术专家带来了巨大挑战。 人工智能架构师安雅·夏尔马博士思考着这些局限性。“我们被界面束缚住了,”她沉思道,“不断地将注意力从现实世界转移到数字指令上。”
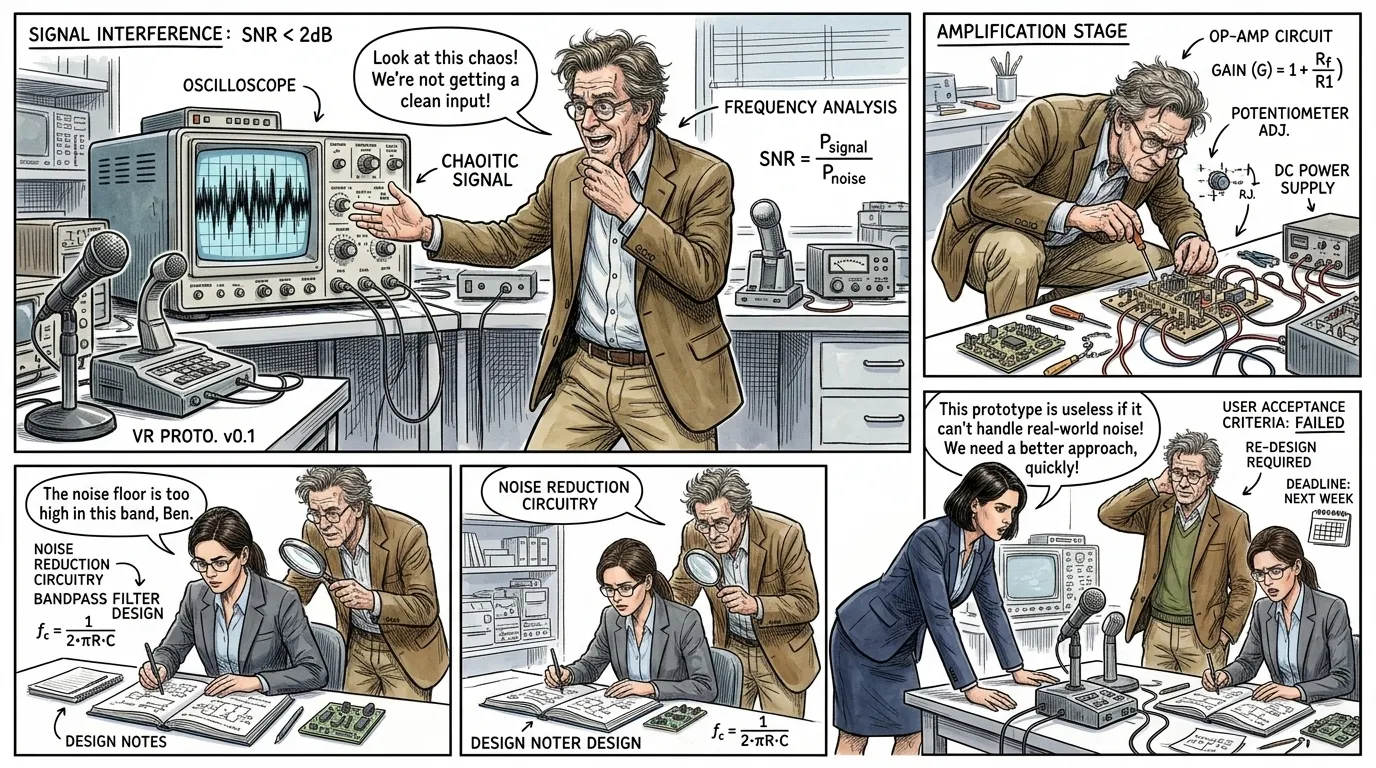
早期对语音控制的尝试,尽管雄心勃勃,却充满了局限性,它们依赖于受限的词汇量,并要求原始的声学环境。研究人员努力应对将复杂人类语音转换为可靠数字命令的根本困难,这似乎是一道难以逾越的技术鸿沟。 “本·卡特教授,一位富有远见的工程师,对着他的团队讲话,同时指着一个闪烁的示波器。“问题不仅仅是词语识别;它在于理解意图并过滤掉世界的噪音。”他强调说,“声学回声消除仍然是我们最关键的障碍之一,它阻碍了清晰的沟通。””
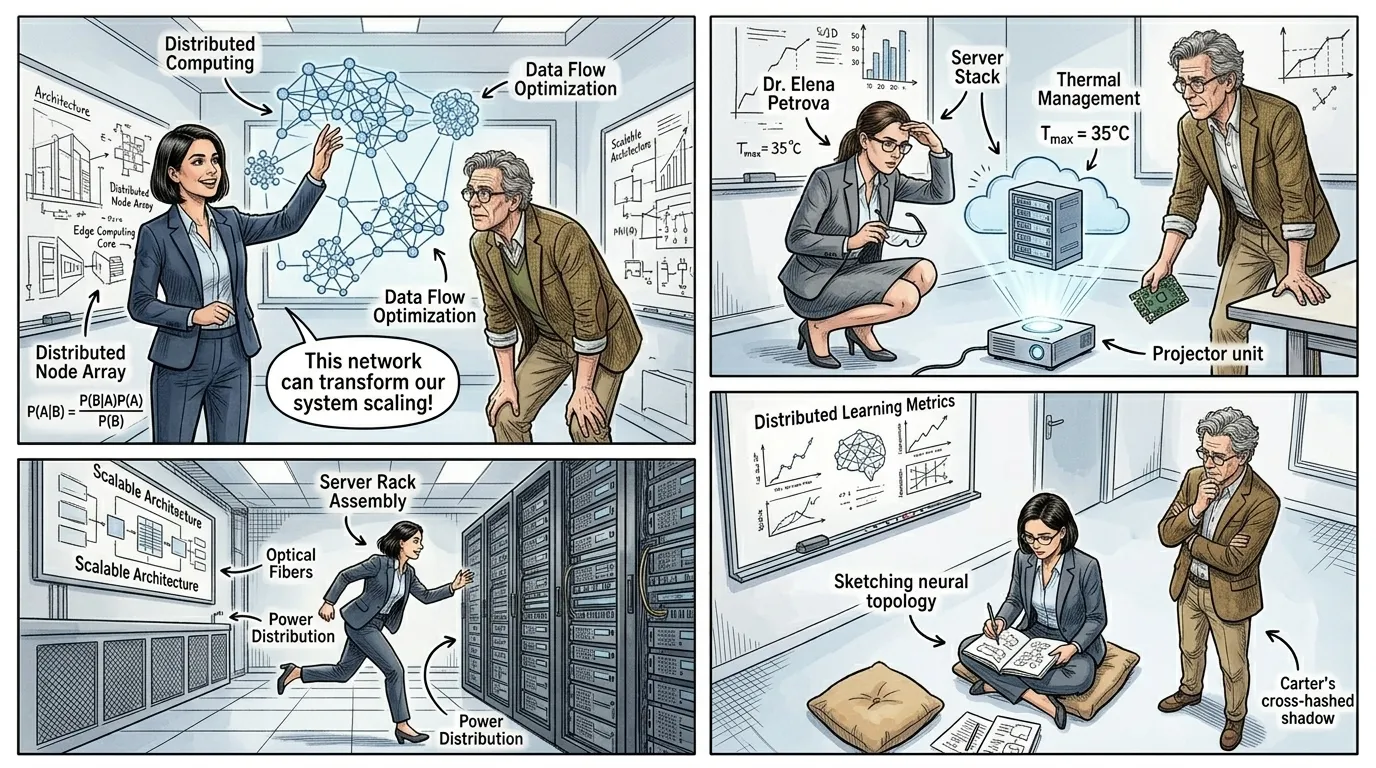
尽管技术障碍持续存在,但真正免提、声控界面的梦想仍吸引着研究人员和创新者,尤其是在亚马逊内部。他们的内部“D项目”旨在超越现有局限,设想一种能够自然理解和响应、无缝融入日常生活的设备。这一追求要求在多个领域取得非凡进展。 “在一次头脑风暴会议中,沙尔马博士轻敲了一张概述神经网络的图表,说道:‘我们必须利用分布式计算和高级算法的力量。正如哲学家阿瑟·C·克拉克曾经说过,‘任何足够先进的技术都与魔法无异’,而我们的目标正是通过不懈的工程努力来创造这种魔法。我们将通过本地智能和庞大云处理的融合,实现真正的‘自然语言理解’。’”
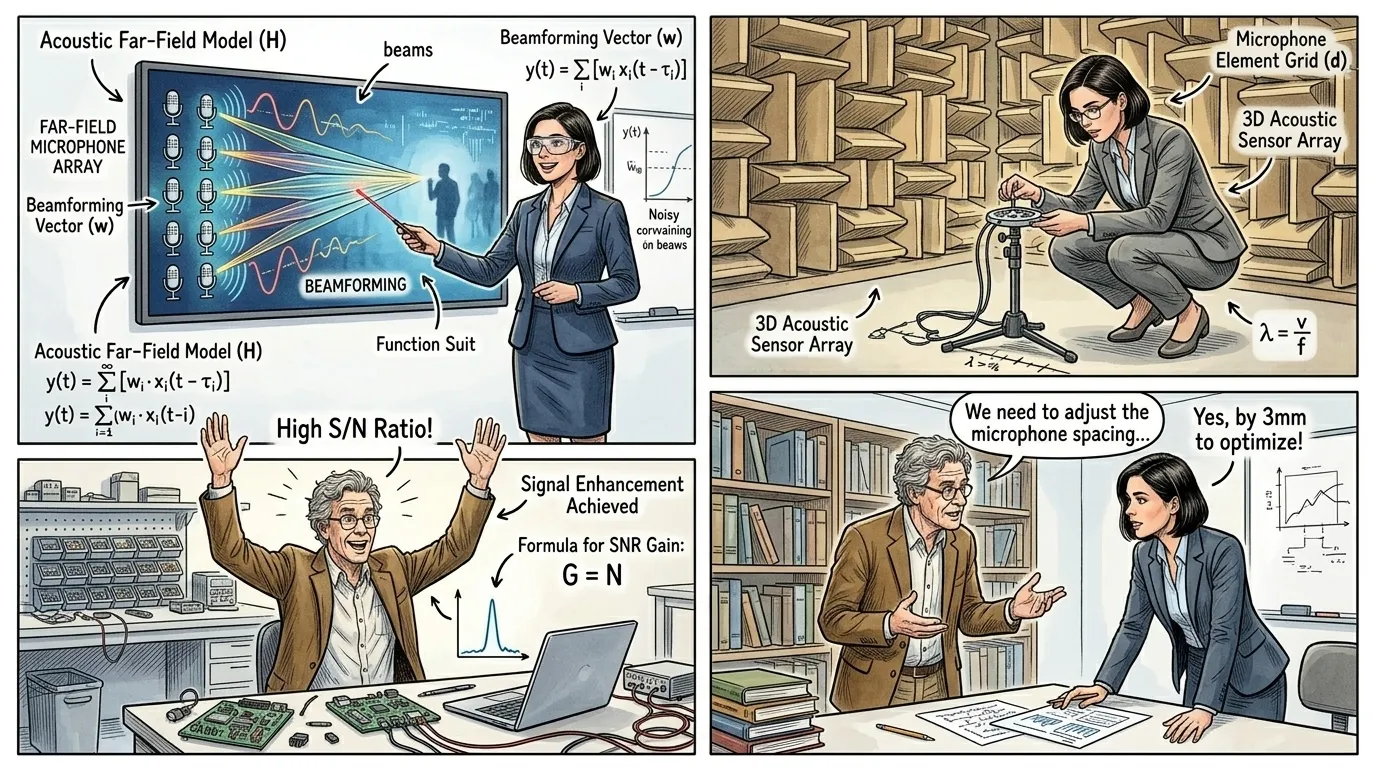
智能音箱的一项关键创新是“远场麦克风阵列”的开发,这是一个复杂的系统,旨在即使在房间噪音中也能准确地从远处捕捉用户的声音。该阵列利用多个麦克风,策略性地放置以检测声源的方向,从而使设备能够专注于说话者并忽略不相关的音频。 声学专家埃琳娜·彼得罗娃博士解释了这项技术奇迹。“通过组合来自多个麦克风的信号,音箱智能地重建声波,有效地创建一个‘波束’来精确定位用户的声音,”她在数字渲染图上演示道,“这种定向捕捉对于将语音从环境干扰中分离出来至关重要,也是实现真正免提交互的关键。”
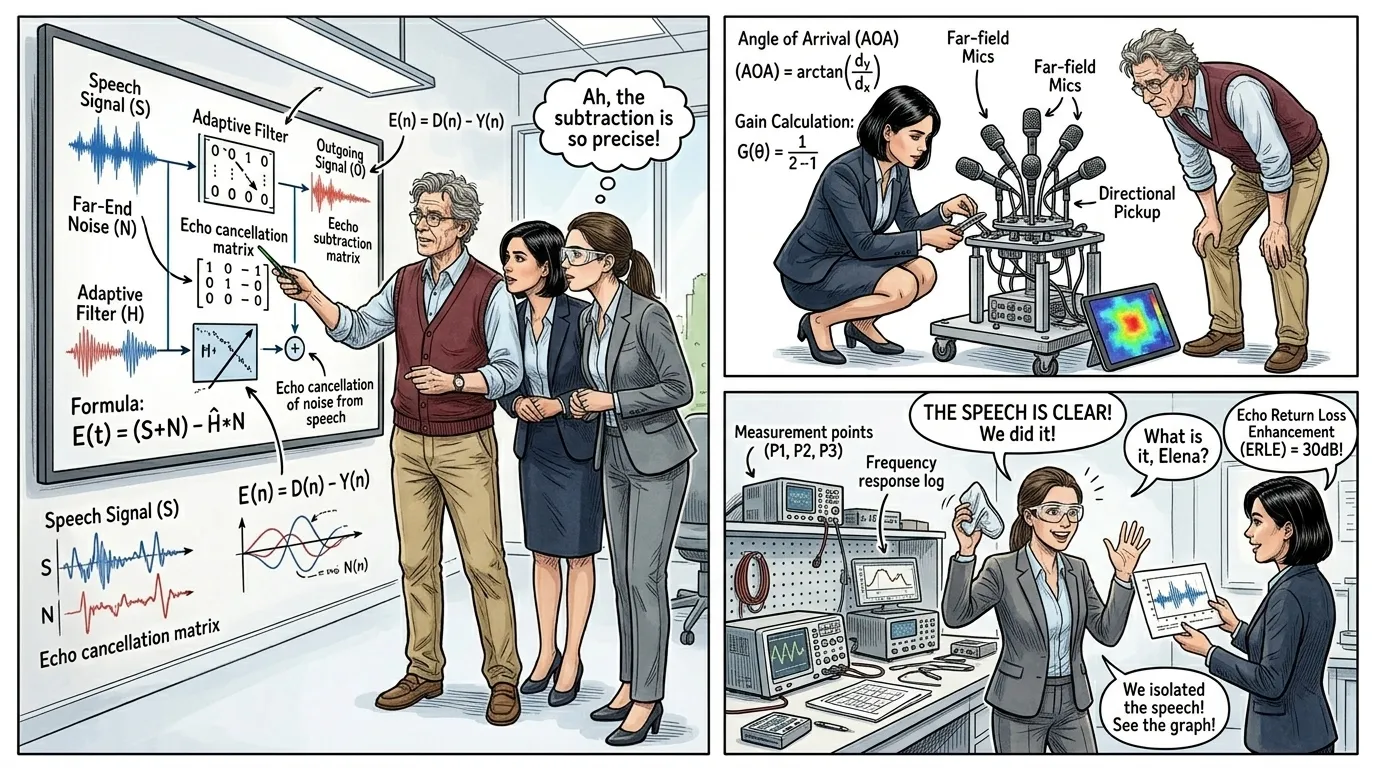
Beyond simply hearing the user, a smart speaker must skillfully manage its own output, ensuring its responses don't interfere with its ability to listen. This required sophisticated Acoustic Echo Cancellation (AEC), an algorithm that intelligently removes the speaker's own audio from the incoming microphone signal. This complex processing allows for seamless, full-duplex communication, preventing the speaker from 'hearing itself' and creating feedback loops. "Professor Carter pointed to a complex algorithm displayed on a screen. "AEC is more than just noise cancellation; it's a sophisticated subtraction problem. We must precisely model the device's output sound and subtract it from the incoming microphone data," he articulated. "Without this, the system would struggle to differentiate a user's command from its own reply, rendering continuous conversation impossible.""
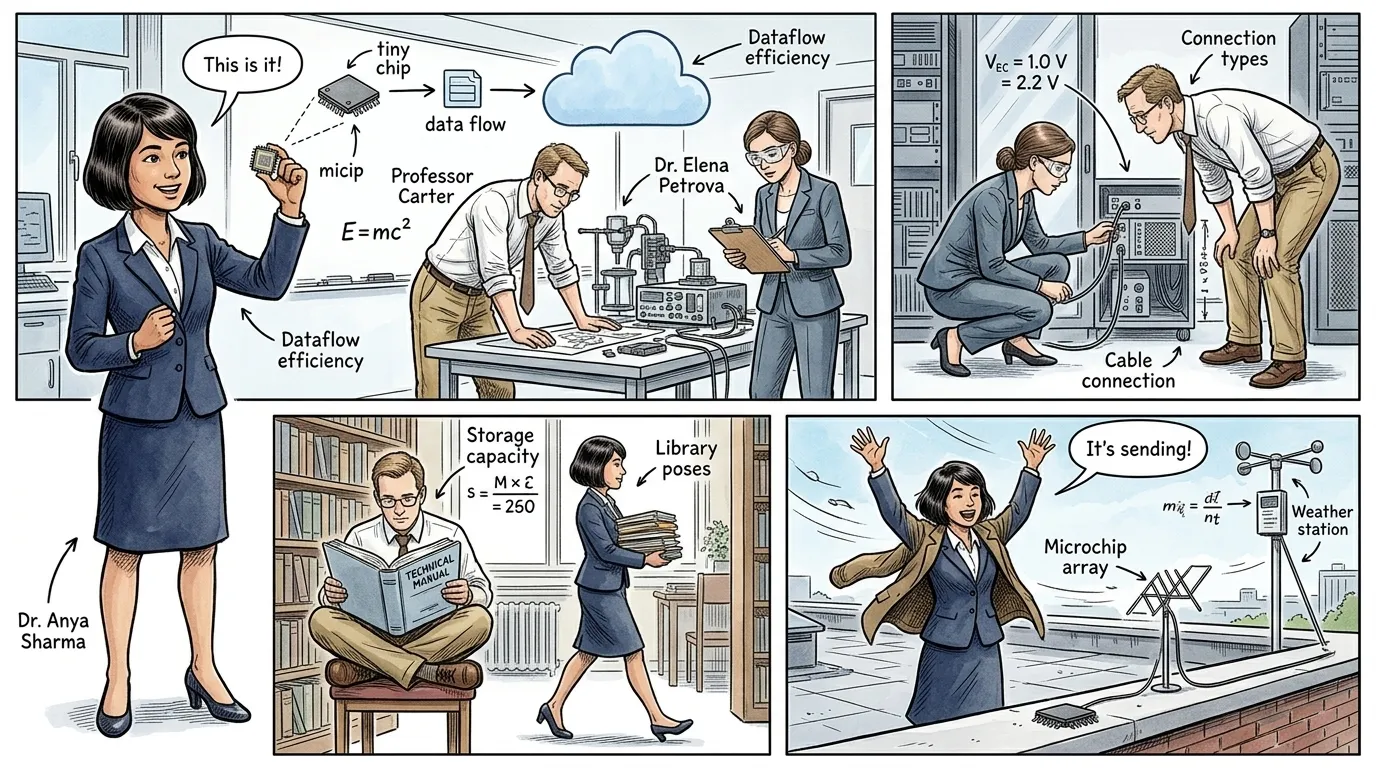
为了解决隐私问题并节省处理能力,智能音箱采用了“唤醒词”检测机制。设备会持续监听一个特定的短语,例如“Alexa”或“嘿 Google”,使用一个低功耗的本地处理单元。只有在识别到这个独特的唤醒词后,设备才会完全激活其高级系统,并开始将捕获到的音频传输到云端进行更深入的分析。 沙尔马博士阐明了关键的设计选择。“‘始终监听’的方面仅限于一个微小、高度专业化的芯片。它只在检测到唤醒词时才唤醒‘大脑’,”她解释道,“这种‘设备上’的本地处理确保了私人对话的私密性,在明确激活之前绝不会离开设备。”
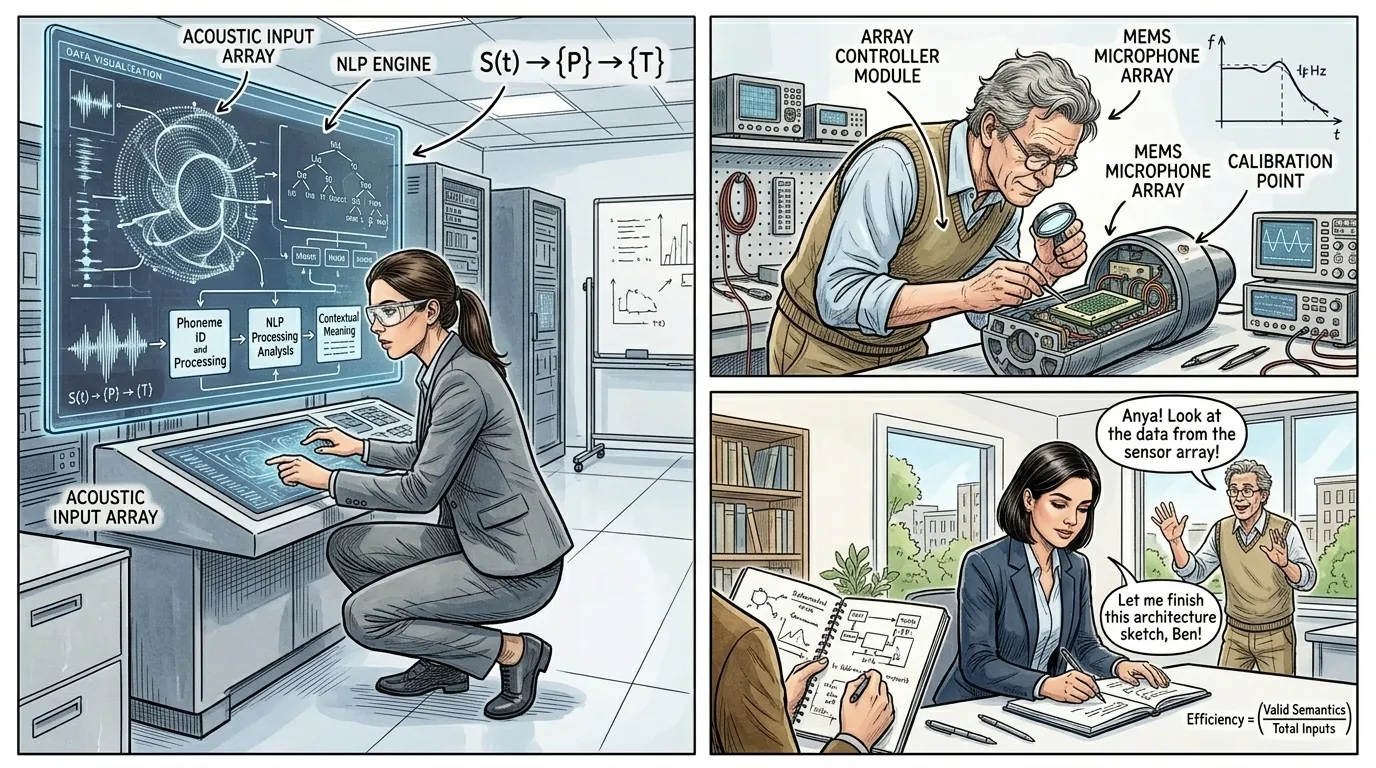
一旦被唤醒词激活,捕获到的音频会迅速加密并传输到强大的云服务器。在这里,先进的自然语言处理(NLP)算法会解析用户的语音,将其转换为文本,然后细致地分析其含义、上下文和意图。这种复杂的“理解”正是智能音箱“智能”的真正所在。 埃琳娜·彼得罗娃博士一边观察大屏幕上复杂的数据结构,一边详细阐述了云的作用。“这就是我们之前谈到的‘自然语言理解’真正发挥作用的地方。云的强大计算能力使我们能够解开人类句法和语义的复杂性,将原始声音转化为可执行的命令和查询。它是解释细微差别的引擎,实现了直观交互的愿景。”
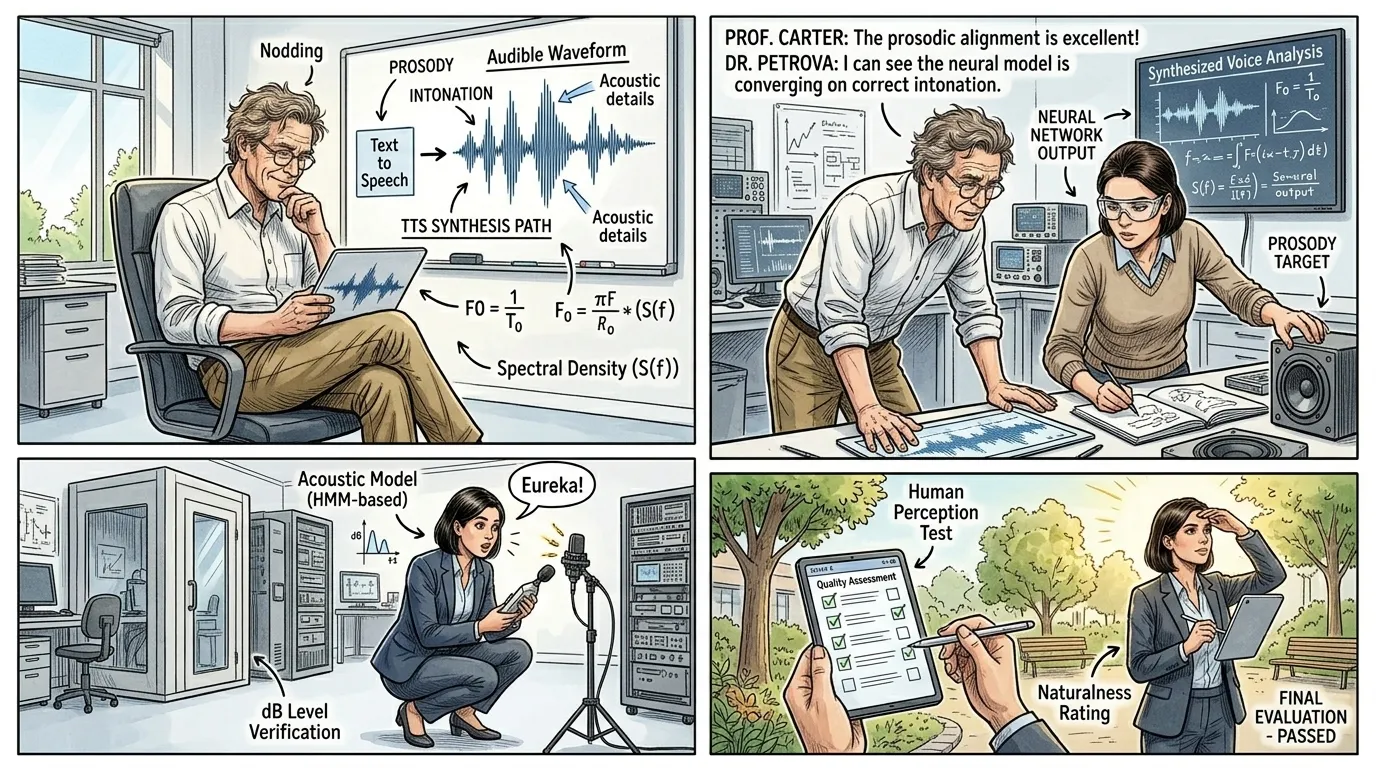
在解读用户意图后,云端人工智能会合成一个相关的回应。这个回应以文本形式呈现,然后通过高度先进的文本转语音(TTS)引擎转换为自然发音的语音。合成的音频随后被传输回智能音箱,在那里播放出来,以清晰易懂的声音完成对话循环。 卡特教授在平板电脑上查看了一个波形,若有所思地点点头。“合成语音的质量至关重要;它决定了用户对智能和有用性的感知。我们的文本转语音算法不断改进,以模仿人类的韵律、语调和情感,”他解释道。“一个真正自然的声音让技术感觉不那么像机器,而更像一个助手,从而培养信任和参与。”
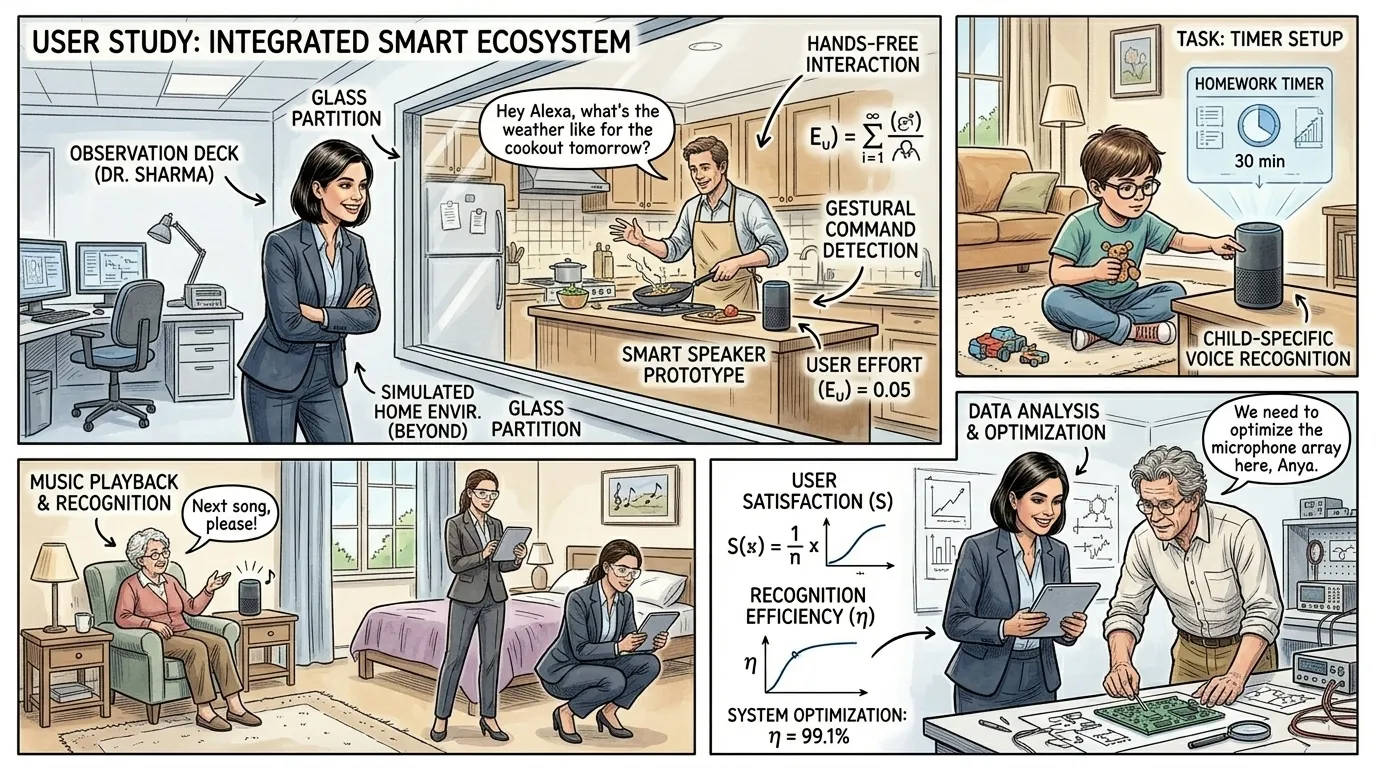
智能音箱的问世,迅速改变了人们在家中与科技互动的方式,标志着普适计算领域的一个重要里程碑。其直观的免提操作,使其迅速成为不可或缺的工具,从管理日常日程到控制智能家居设备,无所不能。这种便捷性将日常琐事转变为无缝互动,展现了对话式人工智能的深远影响。 夏尔马博士观察了家庭在模拟环境中与智能音箱互动的情况。她指出:“它融入日常生活的程度令人惊叹。人们在做饭时可以轻松查询天气,免提设置计时器,还能不间断地播放音乐。这种科技与家庭生活天衣无缝的融合,证明了最初复杂的挑战,例如准确的语音理解和快速响应,都已成功克服,创造了真正直观的体验。”
智能音箱从一个推测性的概念发展成为家庭必备品,这突出表明了人机交互领域的一个根本性范式转变,并激发了语音人工智能更广泛的应用。虽然便利性是其当前成功的标志,但它的传承也引发了关于数据隐私、可访问性以及普及型监听技术的伦理考量等重要讨论。未来有望持续演进,语音界面将变得更加复杂,并进一步融入我们的环境。 卡特教授在反思这一深刻变革时评论道:“智能音箱为环境计算铺平了道路,在这种计算中,技术能够预测我们的需求,而不是要求我们关注。然而,能力越大,责任越大。围绕隐私和道德数据使用的持续对话仍然至关重要,它将塑造下一代智能对话界面。” 他的目光转向实验室窗外未来主义的城市天际线,暗示着一个不断演变的数字景观。