Search Engine — 用中文阅读
故事标题目前仍是英文,正文是中文。
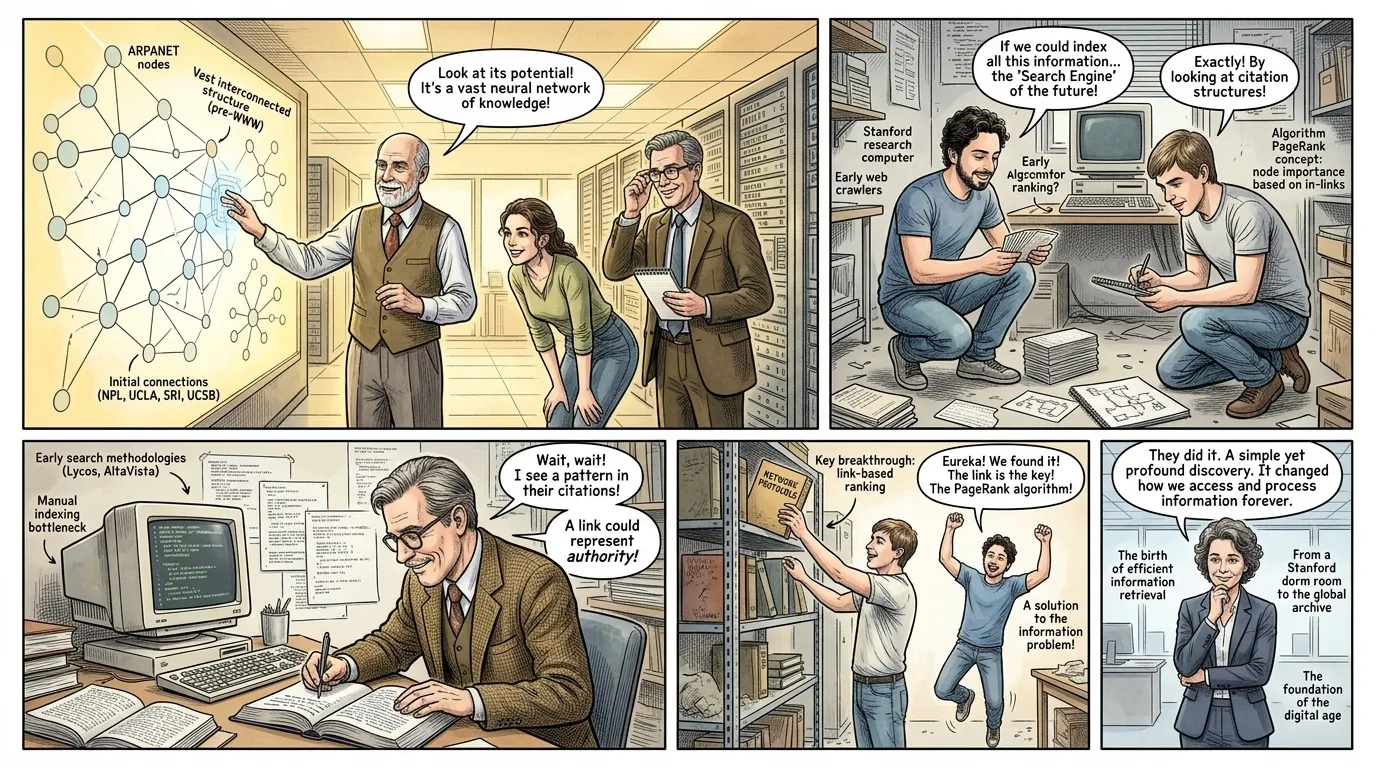
二十世纪末,信息呈爆炸式增长,尤其是随着万维网的兴起。互联网最初被设想为一个用于共享学术论文的强大网络,但它迅速扩展为一个广阔、未知的数字领域。然而,这个无限的知识宝库却呈现出一个深刻的悖论:在不断增长的数据海洋中,人们如何才能找到任何特定的信息?这是早期数字先驱们面临的巨大挑战。 互联网协议的关键架构师文顿·瑟夫博士曾反思早期网络的巨大潜力。“埃莉诺·罗斯福曾说过一句名言:‘未来属于那些相信梦想之美的人。’我们梦想着一个互联互通的世界,但我们很快意识到,这个梦想需要一个索引,一种在海量新信息中找到那种美的方式。”
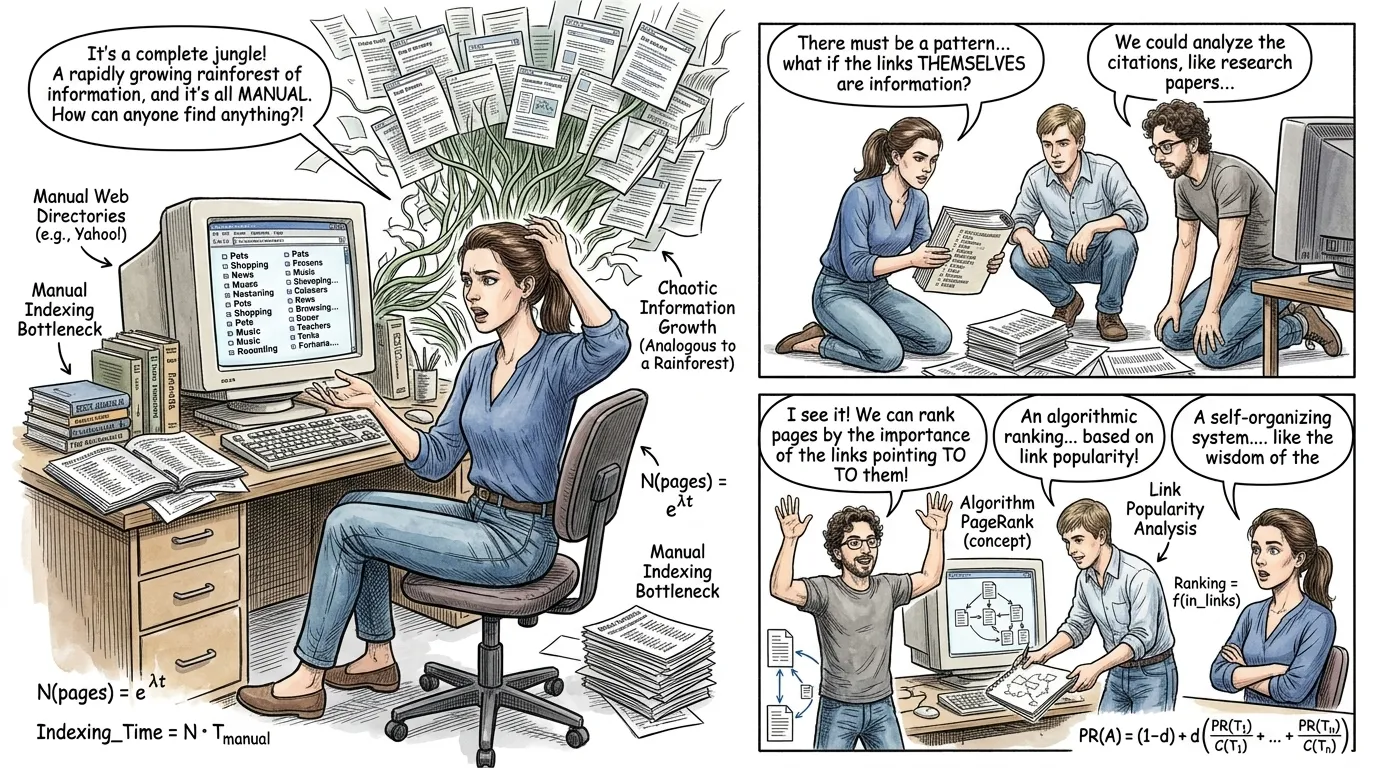
在精密搜索引擎出现之前,用户依赖人工整理的目录,例如雅虎早期的分类目录。这些服务一丝不苟地将网站组织成不同类别,就像传统的图书馆卡片目录一样。虽然提供了一定的结构,但这种人工方法本身就存在局限性,难以跟上新网页指数级增长的速度。此外,那个时代基本的关键词搜索工具只是简单地匹配词语,常常产生无数不相关的结果,掩盖了真正的价值。 一位早期的网页设计师埃拉拉·万斯,在她的办公桌前工作时,表达了她的沮丧。“我记得我花了好几个小时手动向目录提交网站。我们还会和管理员争论分类!那就像试图用手整理一片雨林。每天都有十棵新树长出来,我们根本跟不上修剪的速度。网络需要一些远比这更智能的东西,一些能看到我们看不到的模式的东西。”
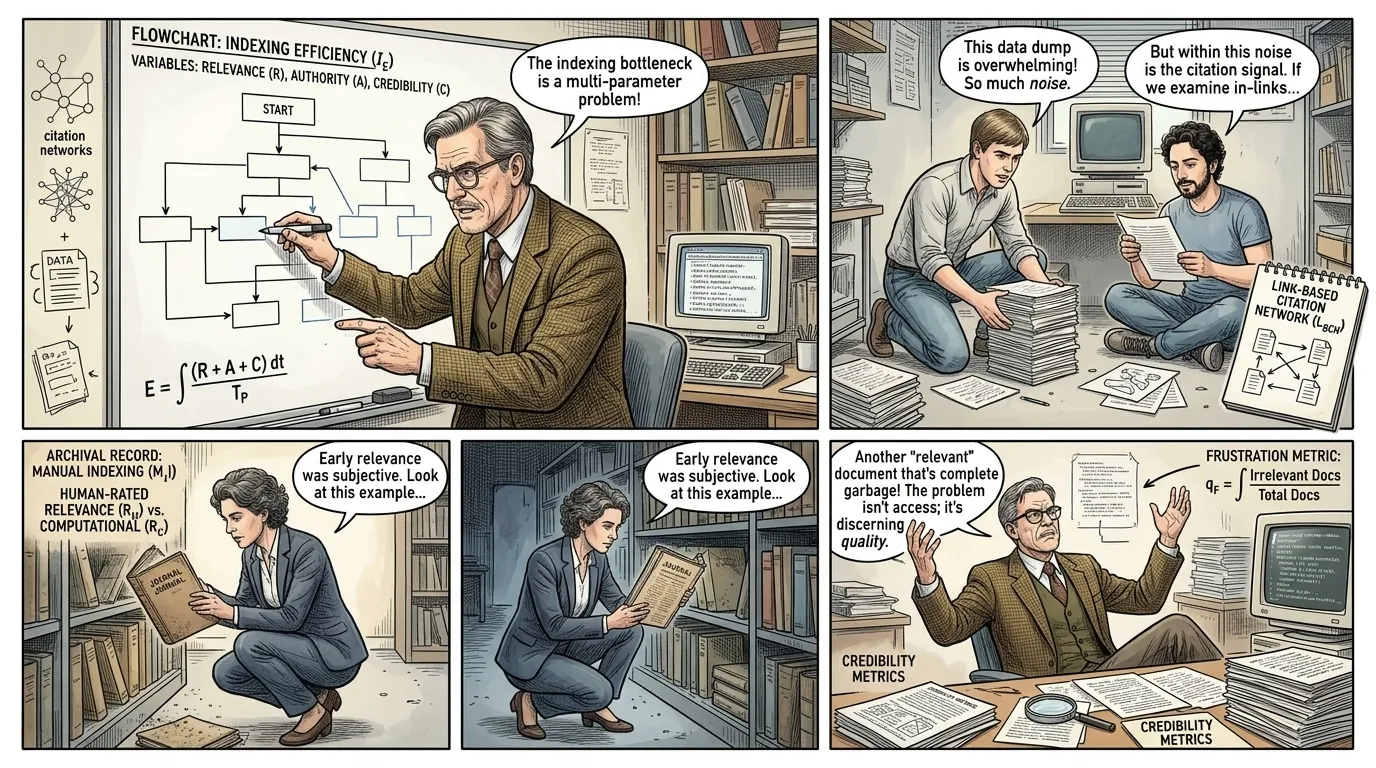
根本问题不仅仅是找到包含特定词语的网页;而是识别相关且权威的页面。搜索“心脏病”可能会返回数千个结果,从医学期刊到个人博客和广告。如果没有一种机制来区分可信度,用户就不得不筛选大量信息,往往不确定哪些来源可以信任。这个“质量问题”是早期网络搜索机制未能克服的关键障碍。 “马库斯·索恩博士,一位因研究在线资源而感到沮丧的学者,讨论了这一挑战。“我们迫切需要一个过滤器,一个质量指标。信息量之大令人应接不暇,但缺乏辨别力则令人瘫痪。正如罗马哲学家塞涅卡所观察到的,‘我们之所以不敢,并非因为事情困难;而是因为我们不敢,事情才变得困难。’这里的困难在于敢于发明一个真正能理解信息价值而不仅仅是其存在的系统。””
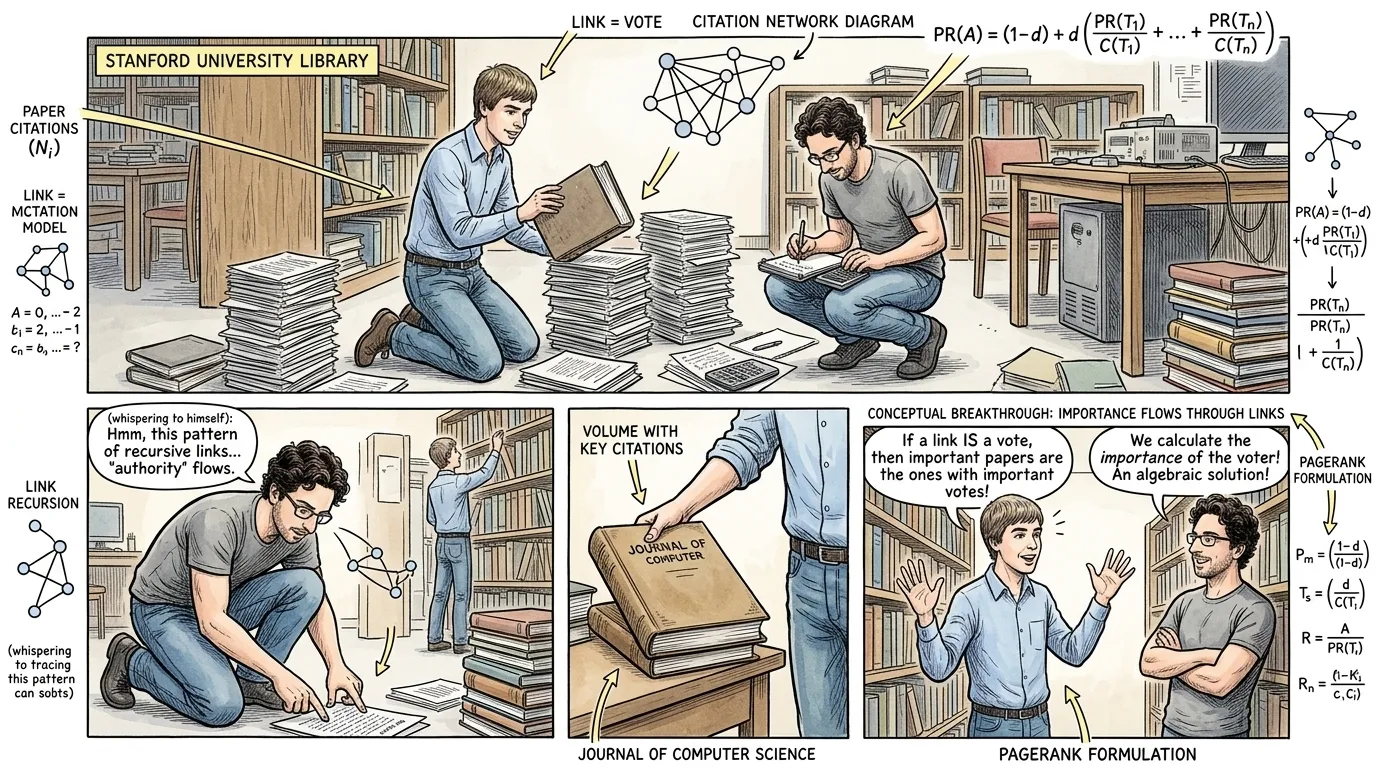
在二十世纪九十年代中期,斯坦福大学的两位博士生拉里·佩奇和谢尔盖·布林开始研究这个问题。他们质疑当时普遍流行的简单关键词匹配方法。他们通过分析学术论文的引用模式,得出了一个激进的见解:一篇论文的重要性往往取决于有多少其他重要的论文引用了它。他们假设这个原则可以应用于网页,将超链接视为“引用”或“投票”。 “拉里·佩奇,一个年轻、瘦削的男人,留着整齐的短浅棕色分头,神情专注,穿着一件休闲的纽扣衬衫,转向谢尔盖·布林。谢尔盖·布林身材健壮,留着深色微卷的头发,戴着眼镜,穿着一件T恤。拉里说:‘谢尔盖,如果像弗朗西斯·培根所说,‘知识本身就是力量’,那么知识之间的链接一定能揭示其真正的力量。如果我们不只是计算提及次数,而是衡量它们的权重呢?来自一所主要大学网站的链接应该比来自个人博客的链接更有意义,不是吗?’”
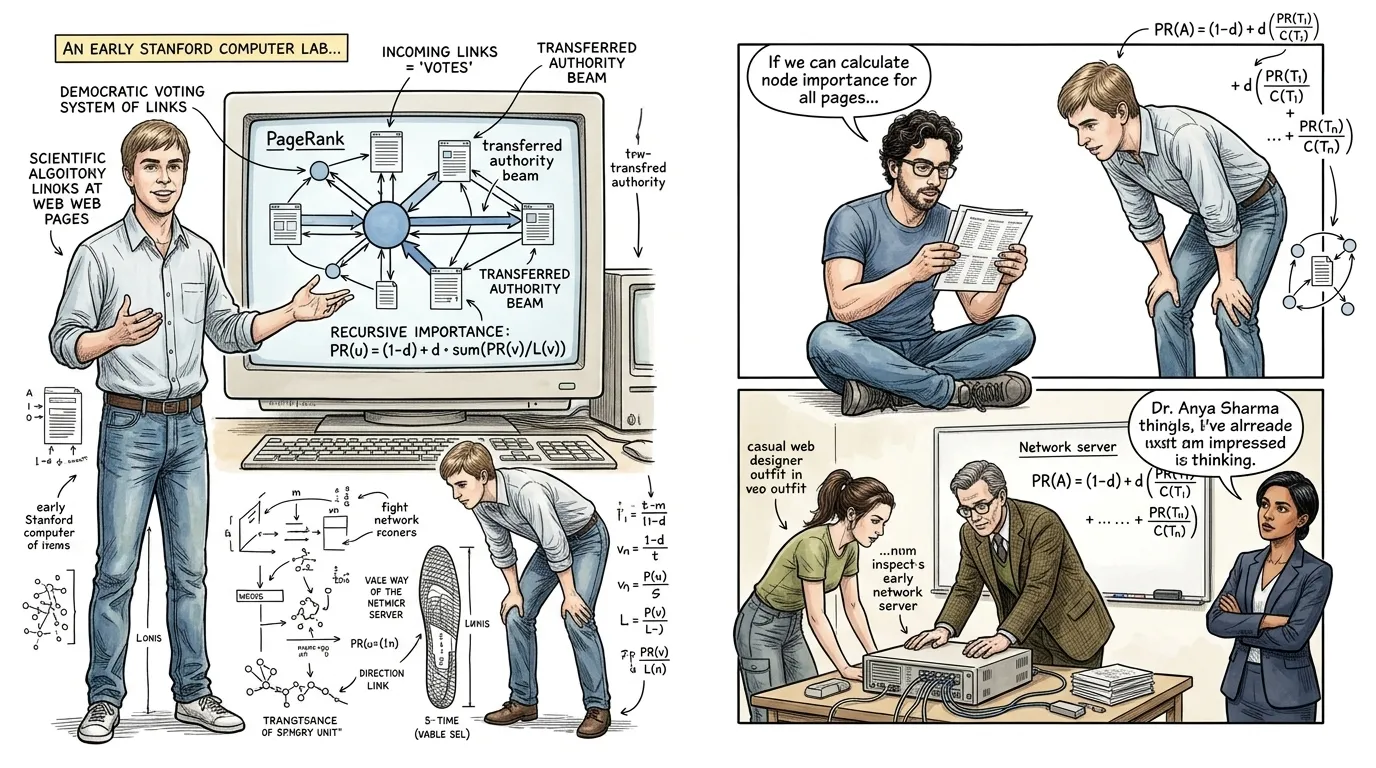
佩奇和布林以拉里·佩奇的名字,将他们创新的排名系统命名为“PageRank”。其核心机制看似简单,实则深远有效:一个网页的重要性由链接到它的网页数量和质量决定。来自高排名网页的链接比来自低排名网页的链接赋予更多的“权威”。这创建了一个递归系统,其中网页的重要性根据其入站链接的重要性不断重新计算。 拉里·佩奇指着显示器上的示意图说:“把它想象成一个网页的民主系统。每个链接都是一张选票。但是,与简单的统计不同,你选票的权重取决于你自己的影响力。如果《纽约时报》链接到一个页面,那比一个不知名的兴趣网站的链接要强得多。我们称之为‘传递权威’。”
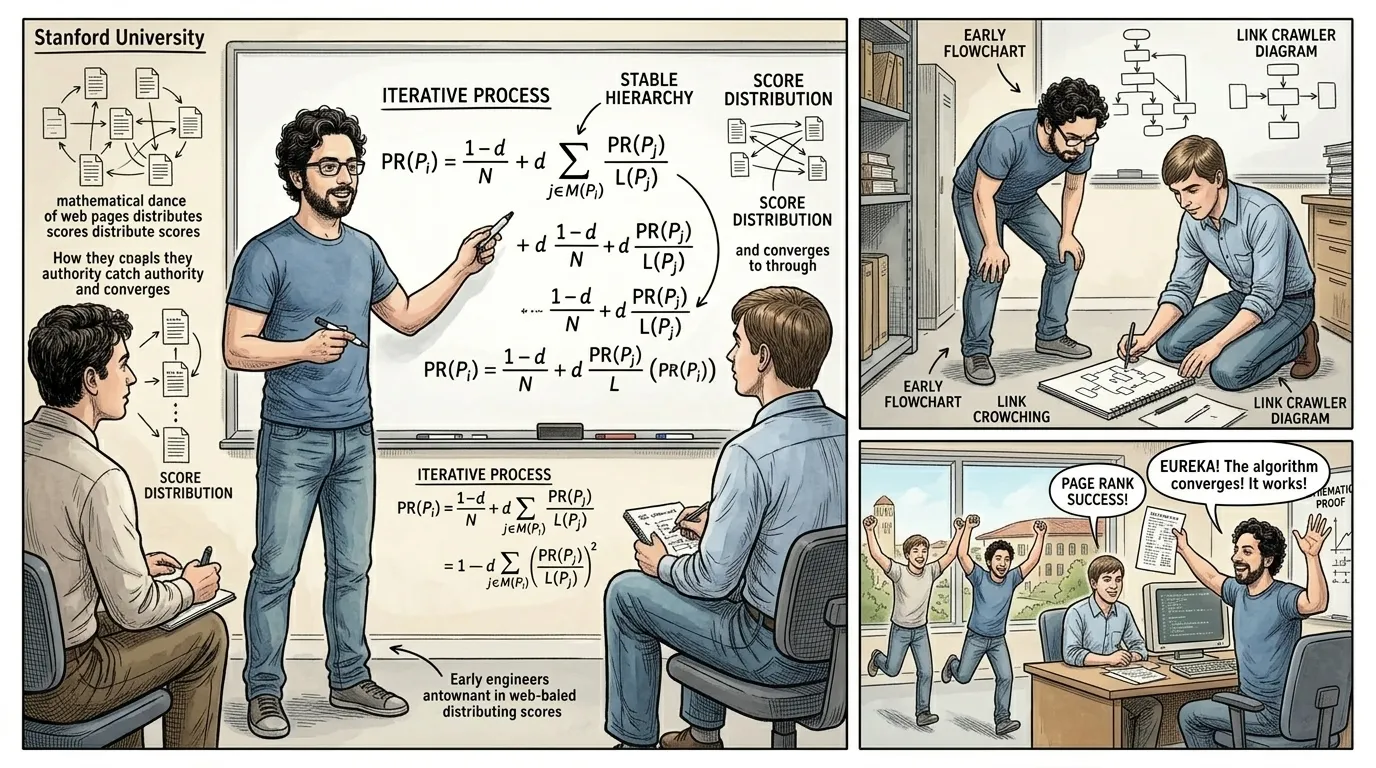
PageRank 算法是一个迭代计算过程。它首先为网络上的每个页面分配一个初始的、相等的 PageRank 分数。在后续步骤中,这个分数会分配给它们链接到的页面。一个页面的新分数是它从传入链接接收到的 PageRank 的总和,按来源页面传出链接的数量按比例分配。这个过程会重复进行,不断优化分数,直到它们收敛,从而创建一个稳定的网页重要性层级。 谢尔盖·布林手持一支笔,指着白板上一个复杂的方程式,向一群早期工程师解释这个过程。“这真是一场数学之舞。每一次迭代都会优化分数。想象一下在一个房间里扔球;一个页面从重要的玩家那里‘接到’球的次数越多,它的分数就越高。它的美妙之处在于它的自我修正性质。它找到了自己的权威平衡点。这不仅仅是为了找到词语,更是为了理解关系。”
由 PageRank 驱动的 BackRub 项目在网页排名方面被证明是极其有效的。佩奇和布林认识到其革命性的潜力,将重心从学术研究转向了创办公司。一九九八年九月,Google 公司正式成立。他们的搜索引擎利用 PageRank,在速度、准确性和用户体验方面始终优于现有竞争对手。迭代的 PageRank 算法虽然计算密集,但经过精心扩展,足以处理不断增长的网络,永远改变了人们获取信息的方式。 拉里·佩奇站在他们初创的谷歌办公室里,对一小队人说:“这不仅仅是一个更好的搜索引擎;这是一种组织世界信息的新方式。我们已经构建了引擎;现在我们必须构建基础设施,让每个人都能使用它。挑战是巨大的,但影响将是深远的。我们不只是在寻找页面;我们是在点亮知识。”
谷歌的公开发布极大地重塑了数字格局。它的速度、简洁的界面,以及最重要的是,其搜索结果的相关性,迅速使其成为主导的搜索引擎。用户不再需要浏览迷宫般的目录,或应对海量低质量的结果。谷歌的PageRank算法为广阔的数字荒野提供了一个可靠的指南针,让人们能够以前所未有的速度找到答案、进行研究并获取信息。互联网终于变得可搜索了。 “技术历史学家埃琳娜·彼得罗娃博士回顾了这一关键时刻。“在谷歌出现之前,网络就像一个没有目录的图书馆,或者说是一本书,所有的书页都被撕掉并散落一地。突然间,我们有了一个索引,一只指引之手。这不仅仅是一项技术进步;它是信息的民主化,是人类知识无与伦比的获取途径的馈赠。它深刻地改变了我们与数据的关系。””
搜索引擎的成功深刻影响了全球经济。它成为企业接触客户的门户,将广告从传统媒体转变为有针对性的在线营销活动。随着消费者可以轻松找到产品和服务,电子商务蓬勃发展。谷歌创新的广告模式 AdWords 允许企业竞标关键词,使广告与用户意图保持一致,创造了一个价值数十亿美元的产业。搜索引擎成为数字经济的引擎,推动创新并连接全球市场。 风险投资家罗伯特·陈在二零零四年的一次采访中讨论谷歌的影响时说:“我们认为这不仅仅是一个工具,它是一个经济引擎。通过用户通过搜索查询表达的意图,如此精确地连接供需的能力,创造了全新的市场。经济学家约翰·梅纳德·凯恩斯曾说过,‘困难不在于新思想,而在于摆脱旧思想。’谷歌向我们展示了如何摆脱旧的商业模式,拥抱一个数字连接的市场。”
如今,搜索引擎不可或缺,它们已经从简单的文本搜索发展到涵盖语音、图像乃至增强现实查询。它们使知识民主化,实现了前所未有的互联互通,并推动了无数创新。然而,它们的影响也引发了关于信息守门人、过滤气泡和错误信息传播的复杂问题。佩奇和布林所解决的根本挑战——组织世界信息——仍在不断演变,推动着人工智能和人机交互的边界。 一位著名的人工智能伦理学家,阿尼亚·夏尔马博士,在最近一次小组讨论中总结道:“搜索引擎给了我们一张地图,但现在我们必须确保它是一张通往智慧的地图,而不仅仅是数据。早期网络的构建者解决了一个巨大的问题,但下一个前沿要求我们解决负责任、公平地获取真相的问题。组织人类知识的旅程远未结束。”